架空の返品FAQが、`購入から30日以内なら返品できます`と答えた。承認済みの規程には、`商品到着から14日以内`とある。この数字は原文との照合で止められる。だが、利用者が商品を開封したか、例外の対象か、規程にない事情をどう扱うかは、同じ照合だけでは答えられない。
生成AIのハルシネーション対策では、正解データや原文、計算規則がある誤りを外部照合で止める。正解がない、まだ決まっていない、文脈で変わる誤りは、用途を狭め、回答保留と人への切り替えを許し、公開後も監視する。万能な検出器を一つ置く問題ではない。
NISTは、出力を既知の正解データへ比較し、人と自動評価を組み合わせるよう提案する。一方、導入前テストが実際の利用場面とずれる限界も示す。産総研も、事実との差を判定するには外部情報が必要で、RAGは取り込んだデータの妥当性までは判断しないと整理する。[1][2]
文章、FAQ、検索、要約など、言葉を公開・共有する利用を想定する。モデルの学習方法や製品比較ではなく、一つの利用場面に、正解の参照先、照合、保留、停止、監視をどう置くかを扱う。法的、医療的、金融的な判断は、分野の専門家と自社規則を別に確認する。
まず、正解を確かめられる仕事か分ける
最初に決めるのは検出ツールではなく、何を正解とするかである。返品期限なら、適用中の規程の版と該当条文が参照先になる。会員名や注文状態なら、権限を管理した業務DBが候補になる。税計算なら、適用条件を含む規則と決定的な計算処理が要る。回答の外に照合先があれば、誤りを具体的に検査できる。
一方、来月の売上予測、`この表現は公平か`という評価、情報が足りない相談、複数の規程が競合する個別案件には、利用時点で一つの正解を置けないことがある。これは何を言ってもよいという意味ではない。正解を確定できない状態そのものを検知し、推測で穴を埋めない応答へ変える。
| 出力 | 正解の参照先 | 検査 | 通らないとき |
|---|---|---|---|
| 日付・金額・名称・状態 | 承認済みDB、規程、原文 | 値、範囲、版を照合 | 回答を止める |
| 要約・引用・抽出 | 入力文書の該当箇所 | 意味、数値、引用範囲を照合 | 原文付きで人へ渡す |
| 計算・変換 | 数式、業務ルール、実行結果 | 決定的な処理で再計算 | 生成結果を使わない |
| 未来・評価・曖昧な依頼 | 一つに定まらない | 不確実性、前提、情報不足 | 保留または追加質問 |
| 個別事情・資料の競合 | 追加情報と専門判断 | 適用条件と不足情報 | 直接答えず担当者へ切り替える |
参照先があっても、それが正しいとは限らない。古い規程、更新されていないDB、対象外の地域、競合する版、誤った入力を正解として置けば、生成AIはその誤りを忠実に返す。参照先には、所有者、版、適用開始日、対象、更新手順を持たせる。使う前に、今回の問いへ適用できるかを確かめる。
ハルシネーションという語も広い。産総研のガイドラインは、入力の文脈からの逸脱、内容の自己矛盾、事実に反する内容などを含める。NISTは、誤った内容を確信的に示すconfabulationをリスクとして扱う。本稿では、事実誤り、与えた資料との不整合、根拠のない断定を中心にする。偏り、重要な欠落、不適切表現は重なり得るが、別の検査も必要である。[1][2]
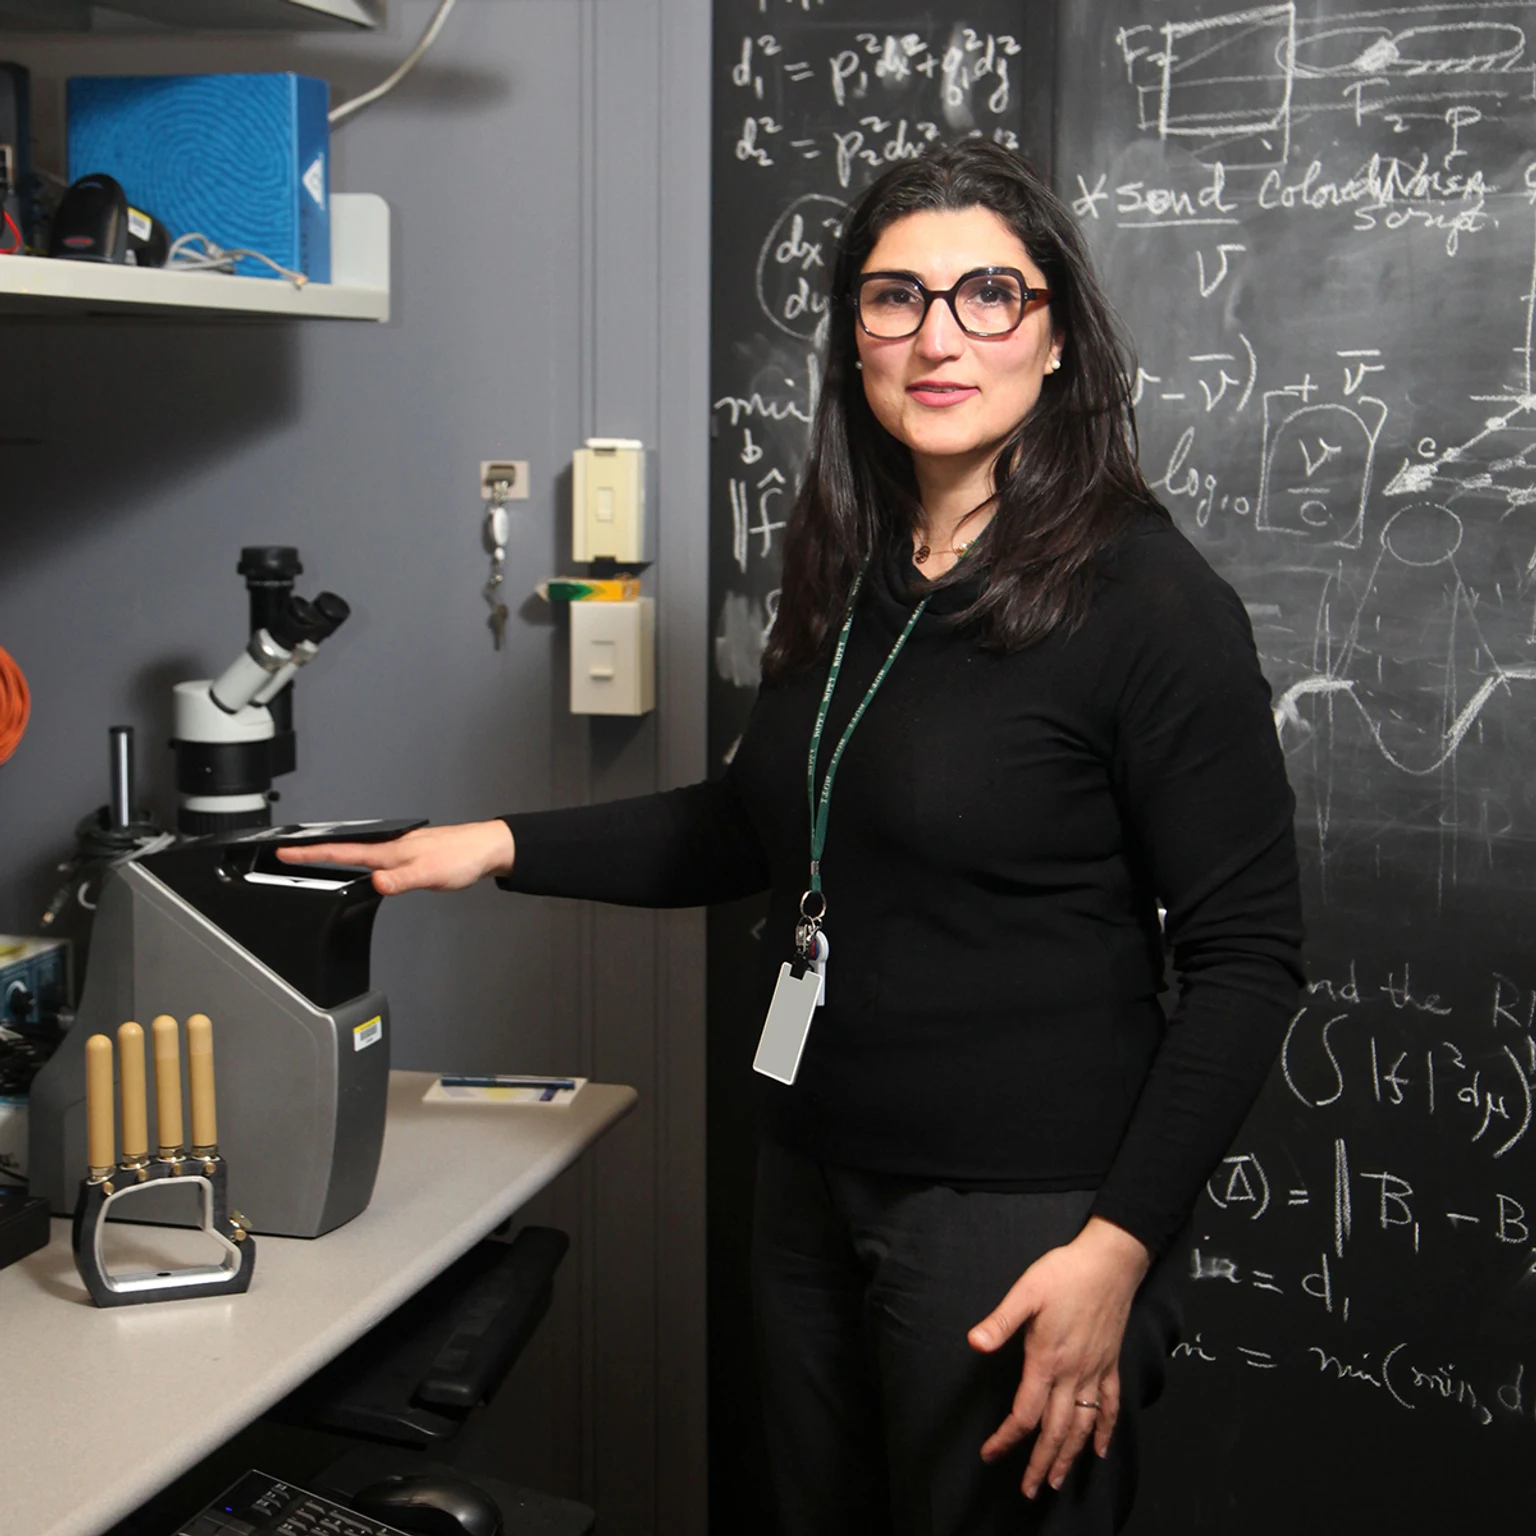
NISTのElham Tabassiが指紋スキャナーを示す写真は、生成AIのハルシネーションを検出する装置ではない。指紋画像の品質を測る標準づくりに関わった研究現場である。生成AIでも、まず測る対象と基準を定め、社会のなかで使われる条件を含めて評価する、という考え方が要る。[9]
英国政府のData and AI Ethics Frameworkは、LLMの出力を人が検証し、誤情報や偏りを確かめるよう求める。意図した用途を十分に安全にできないなら、その問題にAIを使わない。対策の出発点は、誤りを何%減らすかではない。何を確認できないときに答えを出さないかを決めることだ。[7]
照合できる誤りは、生成の外で止める
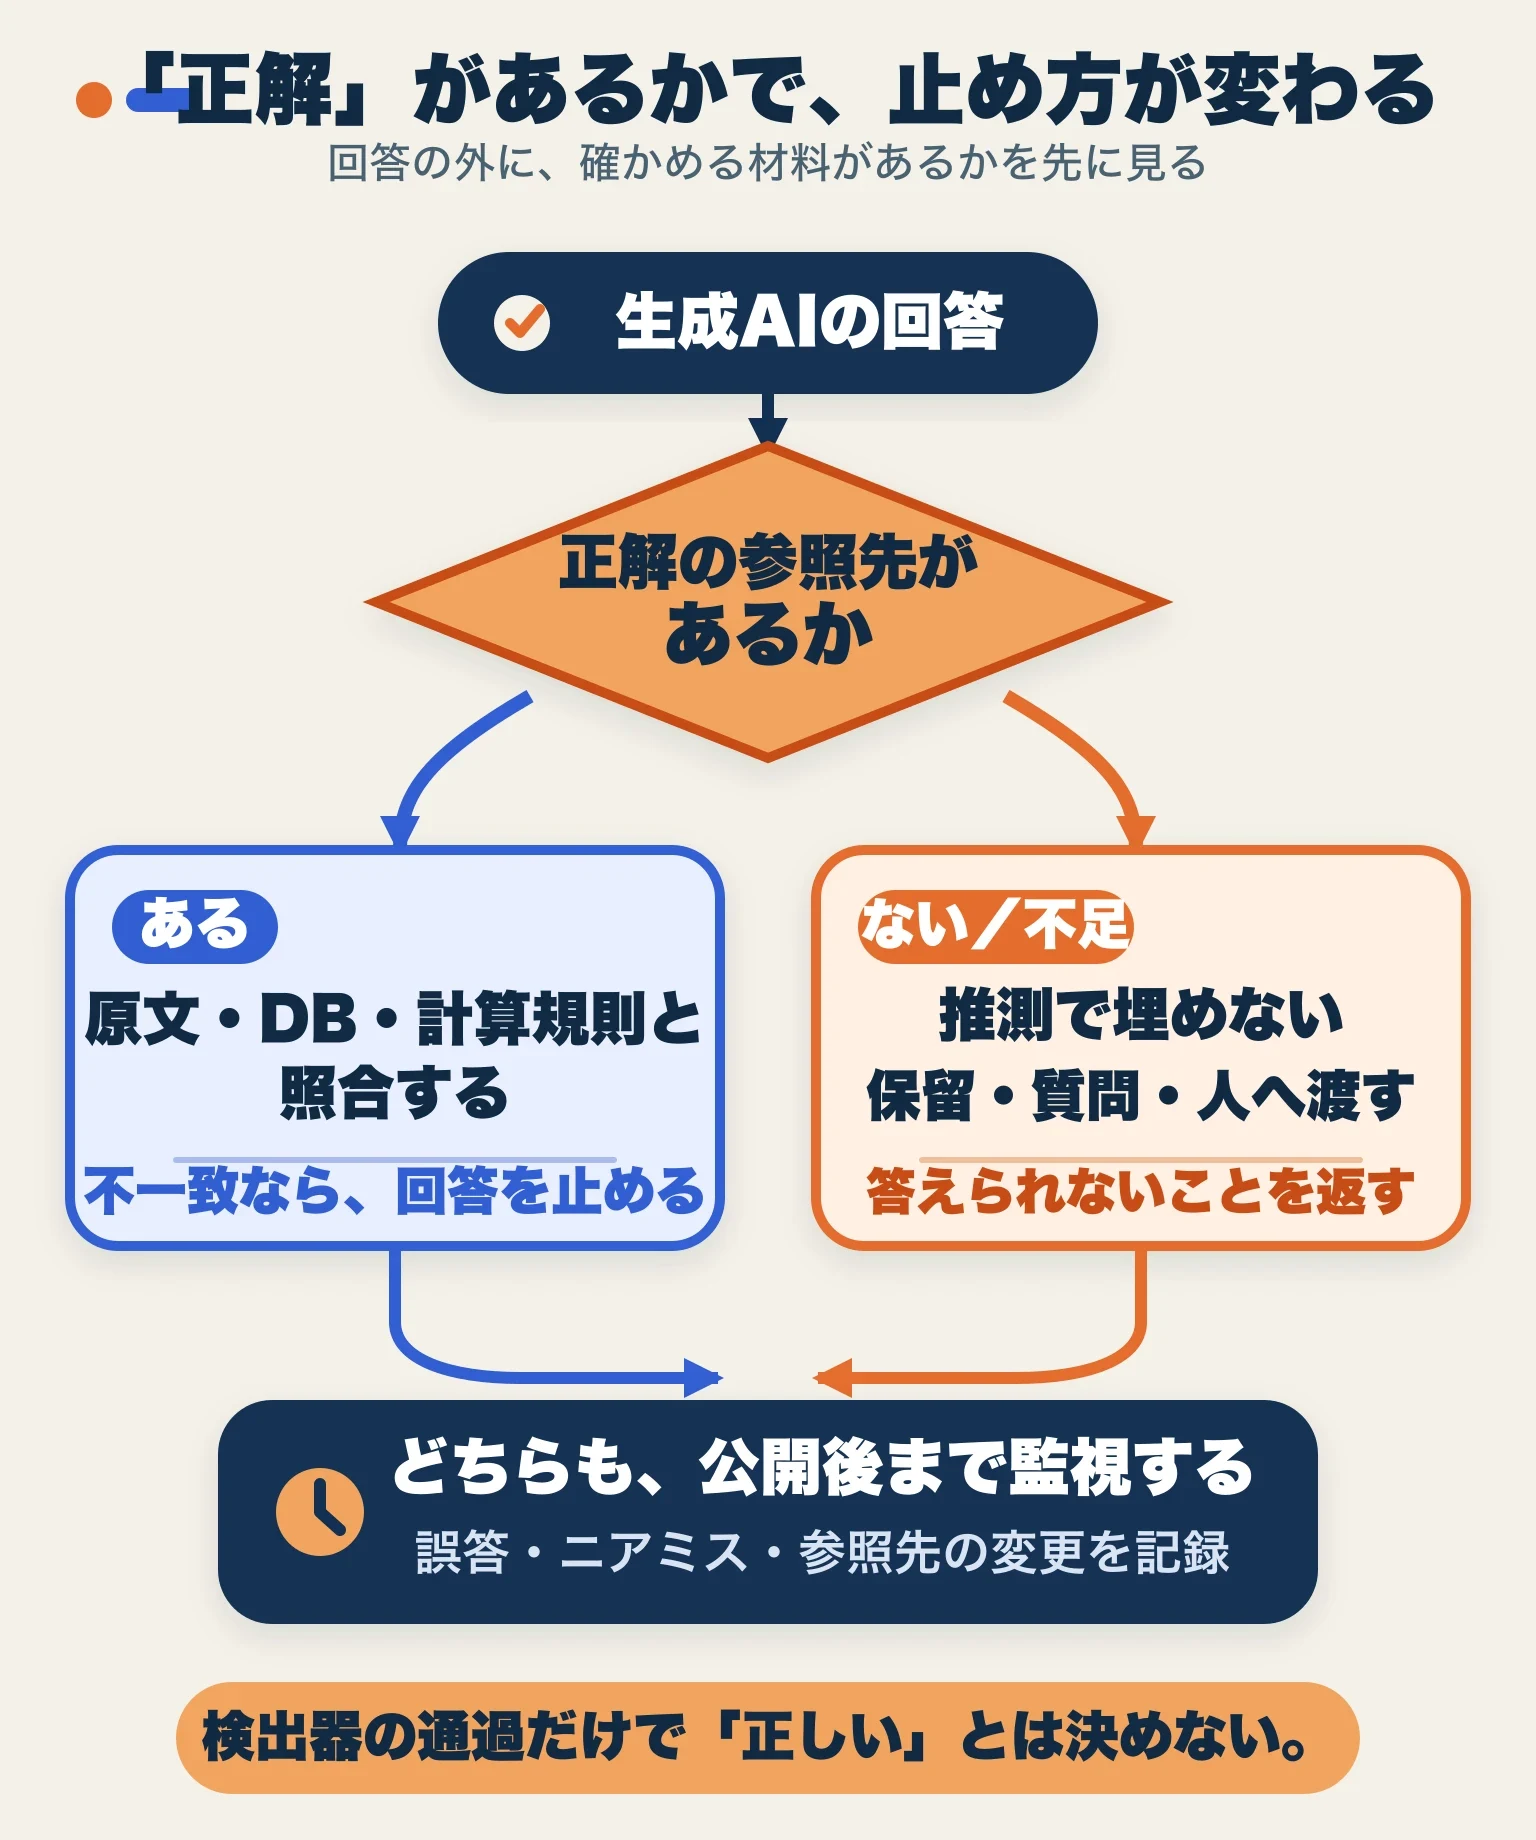
照合先がある仕事では、生成前、生成時、生成後の三か所へ制御を置く。生成前には対象を狭め、使ってよい資料と版を選ぶ。生成時には、その資料だけを根拠に答え、根拠がなければ保留するよう求める。生成後には、回答をモデルの外にある原文、DB、規則へ照合する。
RAGは、質問に関係する外部資料を検索し、生成時の入力へ加える仕組みである。古い学習知識だけに頼る範囲を狭められる。しかし、産総研が示す通り、RAGは取得したデータの妥当性を判断しない。検索漏れ、古い版、対象外の資料、知識の衝突を別に評価する必要がある。[2]
RAGTruthの研究も、RAGを組み込んだモデルが、取得した内容に支えられない主張や、取得内容と矛盾する主張を返し得ることを前提にする。研究は約1万8000件のRAG応答を注釈し、検出手法を評価した。これは特定の研究条件の結果であり、すべてのRAG実装の誤り率ではない。重要なのは、資料を渡す工程と、回答が資料に沿うかを見る工程を分けることだ。[3]
数値や状態は、できるだけ文章生成に計算させない。返品期限の日数、金額、在庫、会員状態を、業務ルールやAPIの実行結果から取得し、定型文の決めた位置へ差し込む。生成AIは説明の構成を担えても、正解が一つに決まる値は決定的な処理へ戻す。
- 入力:利用者の質問、対象、時点、必要な前提がそろっているか
- 検索:承認済み資料の正しい版から、該当箇所を取得できたか
- 生成:回答の各主張が、取得箇所の範囲を越えていないか
- 計算:日付、金額、件数、単位を、規則やコードで再計算したか
- 出力:根拠がない場合に、推測ではなく保留や質問を返したか
要約や引用では、回答に資料名だけを付けず、どの箇所がどの主張を支えるかを結ぶ。出典表示は確認の入口であり、正しさの印ではない。原文の数値、否定、条件、例外を落としていないかを検査する。文字起こしAIを取材で使う工程のように、生成前の原本を残すと後から照合できる。
自動検査には、実際の利用場面から作ったテスト集合が要る。正しい回答だけでなく、古い資料、検索漏れ、競合する規程、曖昧な質問、答えのない質問、もっともらしい誤答を入れる。どの誤りを止められなかったかという偽陰性と、正しい回答を止めた偽陽性を別に数える。許容値は、用途の影響と人が確認できる量から決める。
緑の判定は、設定した検査で止まらなかったことを示す。検査していない主張、正解データにない例外、誤った参照先、未知の入力までは証明しない。Content Credentialsが真偽の印ではないのと同じく、検査結果が保証する範囲を越えて読まない。
照合できない誤りは、検出器だけでは止まらない
外部の正解がなくても、回答の揺れや内部の矛盾を警告へ使う方法はある。同じ問いへ複数回答させ、内容が大きく食い違えば不安定とみなす。意味の不確実性を測り、もっともらしいが任意に変わる回答を拾う研究もある。だが、どちらも正解を新しく作る方法ではない。
SelfCheckGPTは、モデルがある事柄を知っていれば複数の回答が似て、事実でない内容では回答が分岐・矛盾しやすいという考えを使う。GPT-3がWikiBioの人物について作った文章を中心に評価した研究である。回答同士の一致は、外部の事実との一致ではない。共通の誤情報を学習していれば、同じ誤りを繰り返す可能性が残る。[4]
Natureに掲載されたsemantic entropy研究は、言い回しではなく意味の不確実性を使い、confabulationと呼ぶ誤りの一部を検出する。研究自身が、一貫して誤る系統的な失敗には役立たず、事実性を保証しないと境界を置く。警告スコアは、追加確認へ送る順位には使えても、公開許可の証明にはならない。[5]
照合できない場面で必要なのは、正誤の二択より、`答える材料が足りない`という第三の状態である。OpenAIの研究者らは、正解率だけで評価すると、分からないときにも推測する誘因が生まれると論じる。誤答より回答保留を重く評価し、不明と言う、追加情報を求める選択を認める。[6]
返品FAQなら、規程にある一般条件は答えられる。だが、購入経路が不明、開封状況が不明、複数の特約が関わる、利用者が法的な権利の判断を求める、といった場合は直接回答しない。必要な質問を返し、それでも規則へ照合できなければ、問い合わせ番号と原文を添えて担当者へ渡す。
資料にない内容を、モデルの一般知識で補わせない。`該当箇所が見つからない`、`条件が不足している`、`資料が競合している`を別の状態として返す。何が足りないかを示せば、利用者は追加情報を出せる。すべてを滑らかな回答へ畳むと、確認できる事実と推測の境界が消える。
評価も、公開時と同じ利用条件で行う。NISTは、狭いベンチマークや逸話的な試験から能力を一般化せず、導入環境に似た条件で測るよう示す。言語、質問の長さ、資料の版、入力の曖昧さ、モデルやプロンプトの変更を含める。AI時代に文脈が重要になる理由で扱った通り、同じ文も時点と適用範囲を失えば別の意味になる。[1]
最後は、公開範囲と停止条件で抑える
検出しきれない誤りが残るなら、用途の影響と戻しやすさで公開範囲を決める。誤った案を人が捨てられる下書きと、利用者がそのまま行動する公開回答は同じ条件にしない。誤りが人の権利、健康、金銭、安全、評判へ及ぶほど、自動公開から遠ざける。
| 公開区分 | 例 | 条件 | 誤り時 |
|---|---|---|---|
| 補助利用 | 社内の見出し案、検索語候補 | 結果を捨てられ、人が採否を決める | 採用しない |
| 照合後に回答 | 承認済み規程からの一般FAQ | 原文照合、適用範囲、保留応答、ログ | 自動停止して担当者へ送る |
| 人の確認が必須 | 個別事情を含む回答、対外原稿 | 根拠と不足情報を人が確認 | 公開しない |
| 直接出力しない | 高い影響を持つ最終判断 | AIは資料整理まで | 専門手続きへ切り替える |
補助利用では、誤りを見つけた人が結果を簡単に捨てられる。照合後に回答する用途では、使う資料と対象を限定し、根拠がないときに止まる。人の確認が必須の用途では、AIが作った結論だけでなく、参照箇所と不足情報を渡す。直接出力しない用途では、AIを検索や整理までに留める。
人を置けば解決するとも限らない。確認者が原文へ戻れない、量が多すぎる、AIの自然な文章を信用する、責任範囲が曖昧なら、承認は通過儀礼になる。AI企業が編集者を必要とする理由で述べたように、人は文章を読むだけでなく、対象、根拠、読者への影響を判断する。確認できない量を自動化の理由にしない。
公開前テストを通っても、資料、モデル、検索器、プロンプト、利用者の質問は変わる。ログには、入力、取得した資料と版、生成結果、検査結果、保留・切り替え、モデルと設定、確認者、時刻を残す。個人情報や機密は目的と保存期間を決め、必要な範囲だけを扱う。
- 誤答:公開・共有された誤りと、利用者への影響
- ニアミス:検査や人の確認で止まり、公開されなかった誤り
- 保留率:答えを作らず、質問や担当者へ切り替えた割合
- 偽陰性・偽陽性:止めるべき回答を通した件数と、正しい回答を止めた件数
- 変更:モデル、プロンプト、検索設定、正解データ、規程の版
監視指標は、正解率だけにしない。誤答の影響、ニアミス、回答保留、人への切り替え、利用者からの報告、訂正までの時間を見る。英国政府の同フレームワークは、公開後も異常な挙動や有害な出力を継続監視し、予期しない挙動があれば遅くするか停止できる制御を組み込むよう示す。回答保留が増えたときは、無理に減らす前に、参照資料の欠落や質問の変化を調べる。[7]
停止条件は公開前に決める。重大な誤答が一件出た、同じ種類の偽陰性が続いた、規程の更新を反映できない、参照先が失われた、担当者への切り替えが動かない、といった条件で自動回答を止める。英国政府のAI Playbookも、影響と必要な専門知識に応じて人の関与を置き、リスクが高すぎる場合はAI利用自体を再検討するよう示す。[8]
担当者へ渡すときは、AIの回答だけを転送しない。利用者の問い、取得資料、該当箇所、検査で止まった理由、不足情報を一緒に渡す。AI回答を理解せず中継するミート・プロキシを、ハルシネーション対策の最後で再現しない。
まず一つの利用場面を選ぶ。回答の各要素について、何を正解とするか、版と適用条件は何か、どう照合するかを一行で書く。次に、正解を用意できない質問への保留文と追加質問を作る。最後に、人へ渡す条件と、自動回答を止める条件を決める。対策を導入したという事実ではなく、どの誤りをどこで止め、残る不確実性をどの安全な経路へ渡すかが、公開できる範囲を決める。
Sources / 参考資料
2. 国立研究開発法人産業技術総合研究所:生成AI品質マネジメントガイドライン第1版
3. Association for Computational Linguistics:RAGTruth: A Hallucination Corpus for Developing Trustworthy Retrieval-Augmented Language Models
4. Association for Computational Linguistics:SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models
5. Nature:Detecting hallucinations in large language models using semantic entropy
6. arXiv:Why language models hallucinate
7. Government Digital Service:Data and AI Ethics Framework
8. Government Digital Service:Artificial Intelligence Playbook for the UK Government
9. National Institute of Standards and Technology:Minimizing Harms and Maximizing the Potential of Generative AI