エンティティSEOとは、同名の会社・人物・商品を取り違えないよう、公式ページ、対象の種類、固有URL、別名、関係する対象を一貫して示す取り組みである。本稿では、Googleが提供する独立機能や公式の順位対策ではなく、対象を区別する実務上の呼び名として使う。
たとえばCONTEXTは媒体の名前で、株式会社baluboは発行する会社、いま読んでいるページは一本の記事、署名欄は著者を表す。同じドメインに並んでいても、四つは別の対象である。会社名を本文へ何度も足すだけでは、誰が何を発行したのかという関係までは伝わらない。
実務で行うのは、対象ごとに正本となるページを決め、正式名と必要な別名をそろえ、固有URLで指し、会社と媒体、記事と著者などを関係で結ぶことだ。これらは検索側が区別する手がかりになるが、ナレッジパネルの表示、検索順位、AI回答への引用を保証しない。
本稿では、企業サイトの一次情報をAI検索へ届ける考え方と、GoogleのAI検索に追加要件がない理由を前提にする。特殊なファイルを増やすのではなく、企業、媒体、記事、人物をどう分け、どう結ぶかを順に整理する。
エンティティSEOは、同じ名前を同じ対象へ結び直す
エンティティは、ほかと区別して指せる人、組織、場所、商品、作品などの対象を指す。ウェブページは、その対象を説明する文書であって、対象そのものとは限らない。一社の会社について、公式サイト、採用ページ、代表者プロフィール、商品ページ、ニュース記事という複数の文書が存在するからだ。
Googleは2012年にKnowledge Graphを紹介した際、同じ語が建造物、音楽家、カジノ、飲食店を指し得る例を挙げ、実在する対象と相互関係を理解する考え方を説明した。重要なのは、文字の並びが一致することではなく、検索した人がどの対象を意味したかを区別することだった。[1]

- 名前:CONTEXT|役割:人が対象を呼ぶためのラベル|同じ名前が別の媒体や一般語を指す場合がある
- 対象:CONTEXTという媒体|役割:ほかと区別したい一つのWebSite|会社、記事、著者とは別に置く
- ページ:https://context.balubo.jp/|役割:対象を説明し、指し示す正本|URLの変更や重複を管理する
Schema.orgの最上位型であるThingには、`name`、`alternateName`、`identifier`、`url`、`sameAs`、`subjectOf`などが定義されている。短い説明で似た対象を区別する`disambiguatingDescription`もある。名前だけでなく、識別子、説明、参照ページ、関連する文書を組み合わせる前提である。[2]
そのため、会社名の出現回数を増やすことは、エンティティSEOの直接回答にならない。同じ名前を十回書いても、それが株式会社、商品ブランド、店舗、代表者のどれか曖昧なら、同じ曖昧さが十回続く。先に決めるのは、何を一つの対象とし、どのページがその対象の正本になるかである。
会社名だけでは、会社・媒体・商品・人物を分けられない
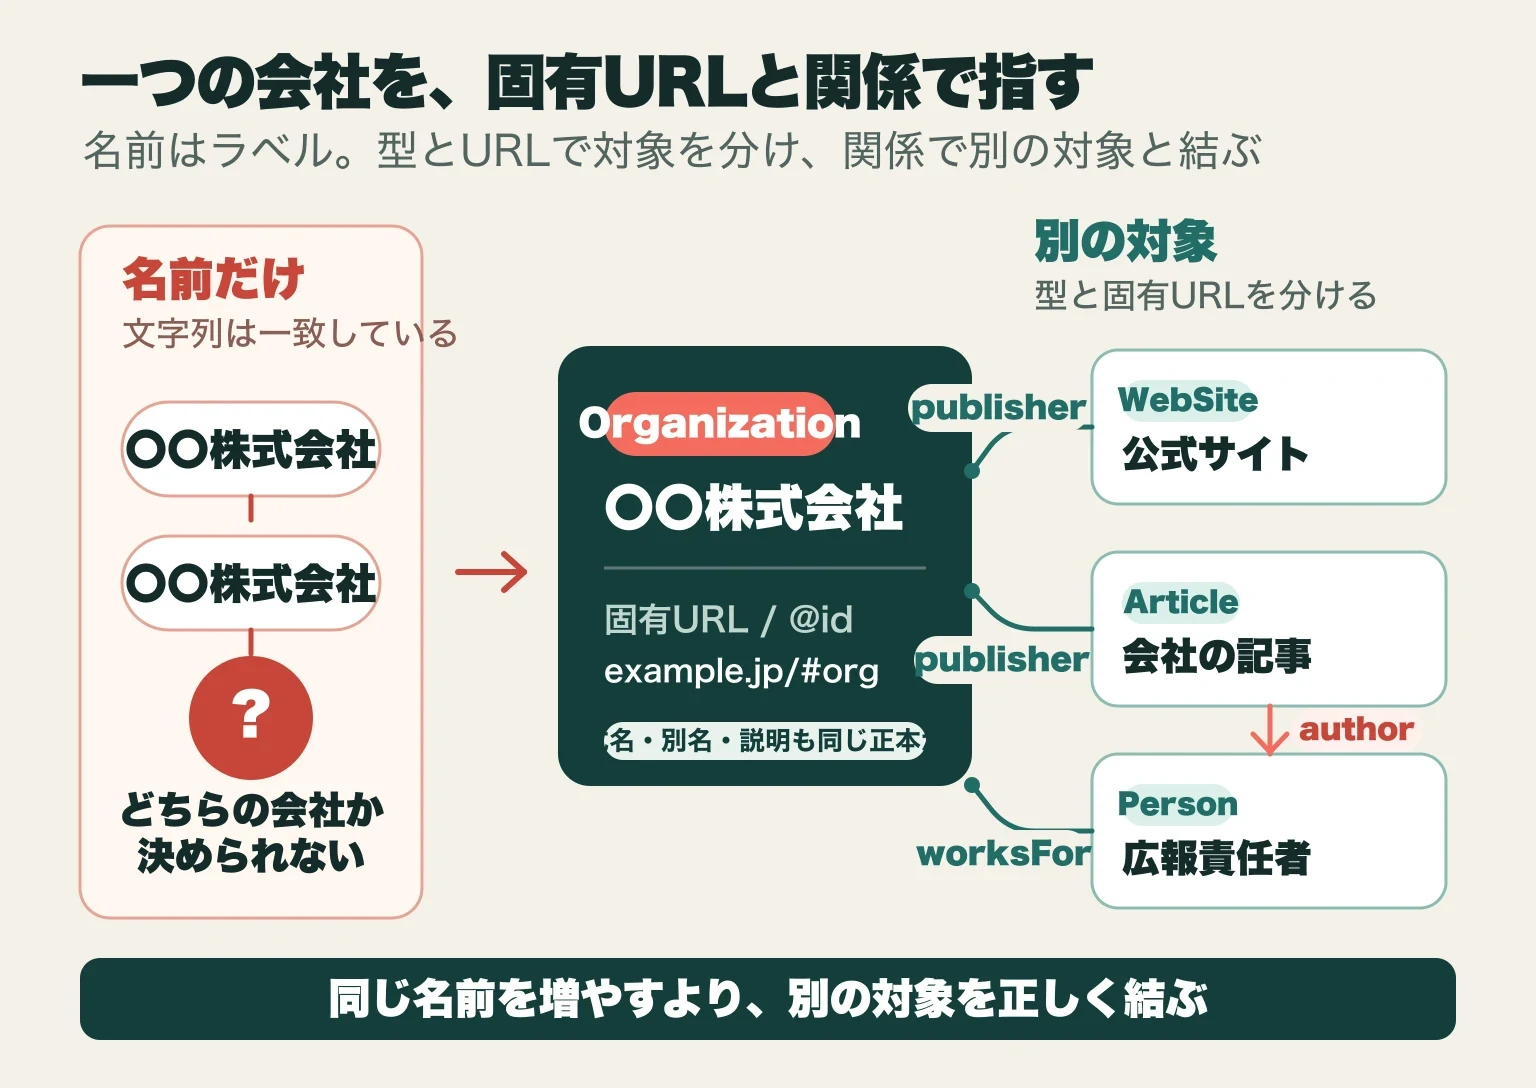
企業サイトには、一つの名前で済ませたくなる対象が複数ある。運営会社はOrganization、ウェブ媒体はWebSite、商品やサービスはProductやService、代表者や著者はPerson、記事はArticleである。型を分けるのは技術上の飾りではない。「会社が媒体を発行し、著者が記事を書いた」という関係を混ぜずに示すためだ。[4][6][12]
| 対象 | 型の例 | 正本の例 |
|---|---|---|
| 運営会社 | Organization | 会社概要・公式サイト |
| 媒体 | WebSite | 媒体トップ |
| 商品・サービス | Product / Service | 公式の商品・サービスページ |
| 代表者・著者 | Person | 公式プロフィール |
| 一本の記事 | Article | 記事のcanonical URL |
Googleは、トップページにOrganization構造化データを置くと、組織の管理情報を理解し、同名組織と区別する助けになると案内する。すべてのページへ置く必要はなく、トップページまたは組織を説明する一ページが推奨される。業態に合う、より具体的な型がある場合は、その型を使う。[4]
最初にそろえるのは、正式な`name`、実際に使われる`alternateName`、公式の`url`、`logo`、住所や電話番号など、利用者にも確認できる情報である。`sameAs`は、同じ対象の身元を曖昧なく示す外部ページへ使う。一般的な関連記事、取引先、掲載実績をまとめて入れる項目ではない。[2][4]
会社名とサイト名も分ける。Googleのサイト名文書では、ホームページのWebSiteに`name`、canonicalの`url`、必要なら`alternateName`を置く。WebSite構造化データは希望を伝える重要な手がかりだが、表示名はホームページの見出しや`og:site_name`なども参照して自動生成され、指定どおりになるとは限らない。[5]
構造化データより先に、画面で読める正本を整える。会社概要には正式名称、所在地、事業内容、責任主体、問い合わせ先を置き、媒体トップには媒体名と運営者を示し、人物ページには所属と役割、商品ページには提供者と対象範囲を書く。更新日と更新担当を決めなければ、古い正本が最も強い矛盾になる。
2026年10月11日にCONTEXTの公開記事を再確認すると、サイト全体のOrganizationは`https://context.balubo.jp/#publisher`、WebSiteは`https://context.balubo.jp/#website`という別の`@id`を持ち、記事のArticleはpublisherで前者を参照していた。[11] これは会社、媒体、記事を一つの名前へ潰さず、別の対象として結ぶ実装例である。
URLと関係をそろえると、ページをまたいでも同じ対象を指せる
JSON-LDは、対象をノード、関係を線として表せる。W3C JSON-LD 1.1では、`@id`にIRIを置いてノードを識別できる。たとえば一つのOrganizationへ安定した`@id`を与え、WebSiteやArticleのpublisherから同じ`@id`を参照すれば、別々のJSON断片でも同じ発行者を指しやすくなる。[3]
| 項目 | 役割 | 例 |
|---|---|---|
| url | 利用者が対象の公式ページを開くURL | https://example.jp/ |
| @id | JSON-LD内の一つのノードを識別し、別のノードから参照する | https://example.jp/#organization |
| sameAs | 同じ対象の身元を曖昧なく示す別サイトのページを参照する | 確認済みの公式プロフィール |
`@id`にURLとフラグメントを使う方法は、ウェブ上へ新しい閲覧ページを増やすという意味ではない。グラフ内で指す先を安定させる実装である。W3Cの仕様は識別と接続の仕組みを定めるが、その値を置けばGoogleの順位が上がるとは定めていない。[3]
次に、関係へ名前を付ける。Articleの`author`は記事と著者を、`publisher`は記事と発行者を結ぶ。Personの`worksFor`は人物と所属組織を、Organizationの`brand`は会社とブランドを結べる。重要なのは、利用できる項目を全部入れることではなく、画面で確認できる実在の関係だけを選ぶことだ。[6][12][13]
- 会社、媒体、商品、人物、記事を一覧にし、混ざっている対象を分ける
- 対象ごとに、利用者が読める正本ページとcanonical URLを一つ決める
- 正式名、実際に使う別名、説明、所在地、運営者などを正本へ明記する
- ページの主題に合うSchema.orgの型を選び、画面と同じ値を出す
- 同じ対象へ安定した@idを使い、publisher、author、worksForなど実在する関係で参照する
- sameAsは、同一性を確認できる公式プロフィールや公的な登録ページだけへ使う
- 構文、クロール、インデックス、検索表示、成果を別々に確認し、古い値を直す
同じ値を複数の場所へ手入力すると、会社名の変更、移転、代表交代、媒体名の変更で矛盾が生まれる。CMSや設定ファイルに正本を持ち、画面、メタデータ、構造化データから同じ値を参照する。文字列が一致しているかだけでなく、会社と媒体を誤って同じ型にしていないかも確認する。
Googleは、構造化データをページ内容の理解に使う一方、不完全または不正確な項目を増やすより、少数でも完全で正確な情報を勧める。ページ上で読者に見えない事実、確認できない所属、終了した商品、実際とは異なる別名を機械向けだけに書かない。[7][8]
ナレッジパネル、順位、AI引用は別の結果として測る
対象と関係を正しく書けたことは、検索結果が望む形になったことと同じではない。Googleは、正しい構造化データでもリッチリザルトの表示を保証しない。Organizationの情報は同名組織の区別やロゴ候補に役立つが、ナレッジパネルを登録して必ず表示させる申請書ではない。[4][8]
| 段階 | 確かめること | 証拠 |
|---|---|---|
| 実装 | 型、値、@id、関係が意図どおりか | HTMLとSchema Markup Validator |
| 取得 | 検索側が正しいURLとHTMLを読めるか | HTTP、robots、canonical、URL検査 |
| 登録 | 正本URLがインデックスに入ったか | Search ConsoleのURL検査 |
| 表示 | サイト名、ロゴ、ナレッジパネルなどへ反映されたか | 実際の検索結果を継続観察 |
| 成果 | 指名検索、自然検索流入、問い合わせがどう変わったか | Search Console、解析、問い合わせ記録 |
GoogleのナレッジパネルはKnowledge Graphの情報を使い、公開ウェブ、ライセンスデータ、内容を所有する主体など複数の情報源から事実を集めて自動生成される。一定の要件を満たす対象の関係者は内容の修正を提案できるが、サイト側が一つの項目を書けば作成や表示を制御できるものではない。[9]
サイト名も自動選択である。WebSiteの`name`を直しても、Googleが再クロールし、処理するまで数日から数週間かかる場合がある。反映されないときは、構造化データだけでなく、ホームページの見出し、タイトル、`og:site_name`、別名、canonicalが同じ対象を示しているかを見る。[5]
検索順位やAI回答への引用も別の評価を含む。GoogleはAI OverviewsやAI Modeへの表示に追加の技術要件や専用schemaを求めていない。エンティティに関する手がかりを整えても、質問との関連性、本文の有用性、鮮度、競合する情報源などを飛び越えて採用を保証することはできない。[10]
- 会社名、媒体名、商品名、人物名を、一つの対象として混ぜていないか
- 対象ごとに、利用者が読める正本ページと安定したURLがあるか
- 正式名、別名、説明、所属、運営者が画面と構造化データで一致するか
- @idは同じ対象で使い回し、別の対象には別の@idを与えているか
- sameAsの参照先は、話題が近いページではなく、同じ対象を明確に指すか
- 表示や順位を保証する表現ではなく、検出後の観察方法まで決めたか
エンティティSEOの出発点は、名前を増やすことではなく、対象を分けることにある。会社、媒体、商品、人物、記事にそれぞれ正本と固有URLを置き、確認できる関係だけを結ぶ。すると検索側へ、単語の一致より具体的な手がかりを渡せる。実装、取得、登録、表示、成果を分けて確かめれば、ナレッジパネルやAI引用を約束せずに、企業情報の取り違えを減らす運用を続けられる。
Sources / 参考資料
2. Schema.org:Thing
3. W3C:JSON-LD 1.1
4. Google Search Central:Organization structured data
5. Google Search Central:Site names in Google Search
6. Google Search Central:Article structured data
7. Google Search Central:Introduction to structured data markup in Google Search
8. Google Search Central:General structured data guidelines
9. Google:A reintroduction to our Knowledge Graph and knowledge panels
10. Google Search Central:AI features and your website
11. CONTEXT:Google AI Modeとは——従来検索と変わる探索の流れ
12. Schema.org:Organization
13. Schema.org:Person