アクセスログに、OAI-SearchBot、GPTBot、ClaudeBot、PerplexityBotといった名前が並ぶ。まとめて『AIクローラー』と呼ばれるが、名前にAIが付く訪問を一括で許可したり拒否したりすると、検索で見つけられる機会と、モデル学習への利用、利用者に頼まれた一回の取得を同時に扱うことになる。
AIクローラーとは、AIサービスがWebページを自動的に、または利用者の指示を受けて取得する仕組みの総称である。本稿では、取得後の主な行き先に合わせて『検索』『学習』『ユーザー代理』の三つに分ける。同じ会社でも目的ごとにbot名や制御方法が異なり、拒否した後に起きることも同じではない。
この三分類は、各社共通の正式規格ではなく、発信側が判断するための整理である。広告審査など別目的のbotもあり、一つの取得結果が複数の用途へ使われる場合もある。したがって、アクセスログのUser-Agentだけを見て用途まで断定せず、各社の公式説明、送信元、適用する方針を組み合わせて判断する。
ここでは、AIO・GEO・LLMOの違いで整理した発見性の話を、ページを取りに来る側から捉え直す。GoogleのAI検索で評価される条件も踏まえ、bot名の暗記ではなく、目的と影響を記録する方法まで進める。
同じ会社でも、取りに来る理由は一つではない
OpenAIは、ChatGPTの検索結果へWebサイトを表示するためのOAI-SearchBotと、基盤モデルの学習に使う可能性があるコンテンツを取得するGPTBotを分けている。サイト運営者は一方を許可し、もう一方を拒否できる。ただし両方を許可している場合、重複取得を避けるため、一度のクロール結果を検索と学習の双方に使うことがある。[S1] 目にした一回のリクエストだけから、保存後の用途を一つに絞れない例である。
Googleでは、通常のGooglebotが検索インデックスや検索機能のために自動巡回し、robots.txtに従う。[S2] 一方、Google-Extendedは独立したHTTPのUser-Agentではない。既存のGoogleのクローラーが取得した内容を、将来のGeminiモデルの学習やGemini、Vertex AIのグラウンディングへ使えるかを指定するrobots.txt上の制御名であり、拒否してもGoogle検索への掲載や順位には影響しないと説明されている。[S2] ログでGoogle-Extendedという訪問者を探しても見つからない。
Anthropicも、将来の学習に使う可能性があるWebコンテンツを集めるClaudeBot、検索品質を高めるClaude-SearchBot、利用者の依頼でページへアクセスするClaude-Userを分ける。[S4] Perplexityは、検索結果へサイトを表示しリンクするPerplexityBotと、利用者の操作を支えるPerplexity-Userを公開し、いずれも基盤モデルの学習には使わないとしている。[S5] 同じ『AI企業からのアクセス』でも、目的は会社名だけでは決まらない。
検索・学習・ユーザー代理では、止めた後が違う
三つの違いは、ページを取るきっかけと、取得後の主な行き先に表れる。検索用は自動巡回で検索結果や回答の参照候補を作り、学習用は将来のモデル改善に関わる。ユーザー代理は、利用者がURLを開く、質問への回答を求める、エージェントへ操作を頼むといった、その場の依頼から始まる。
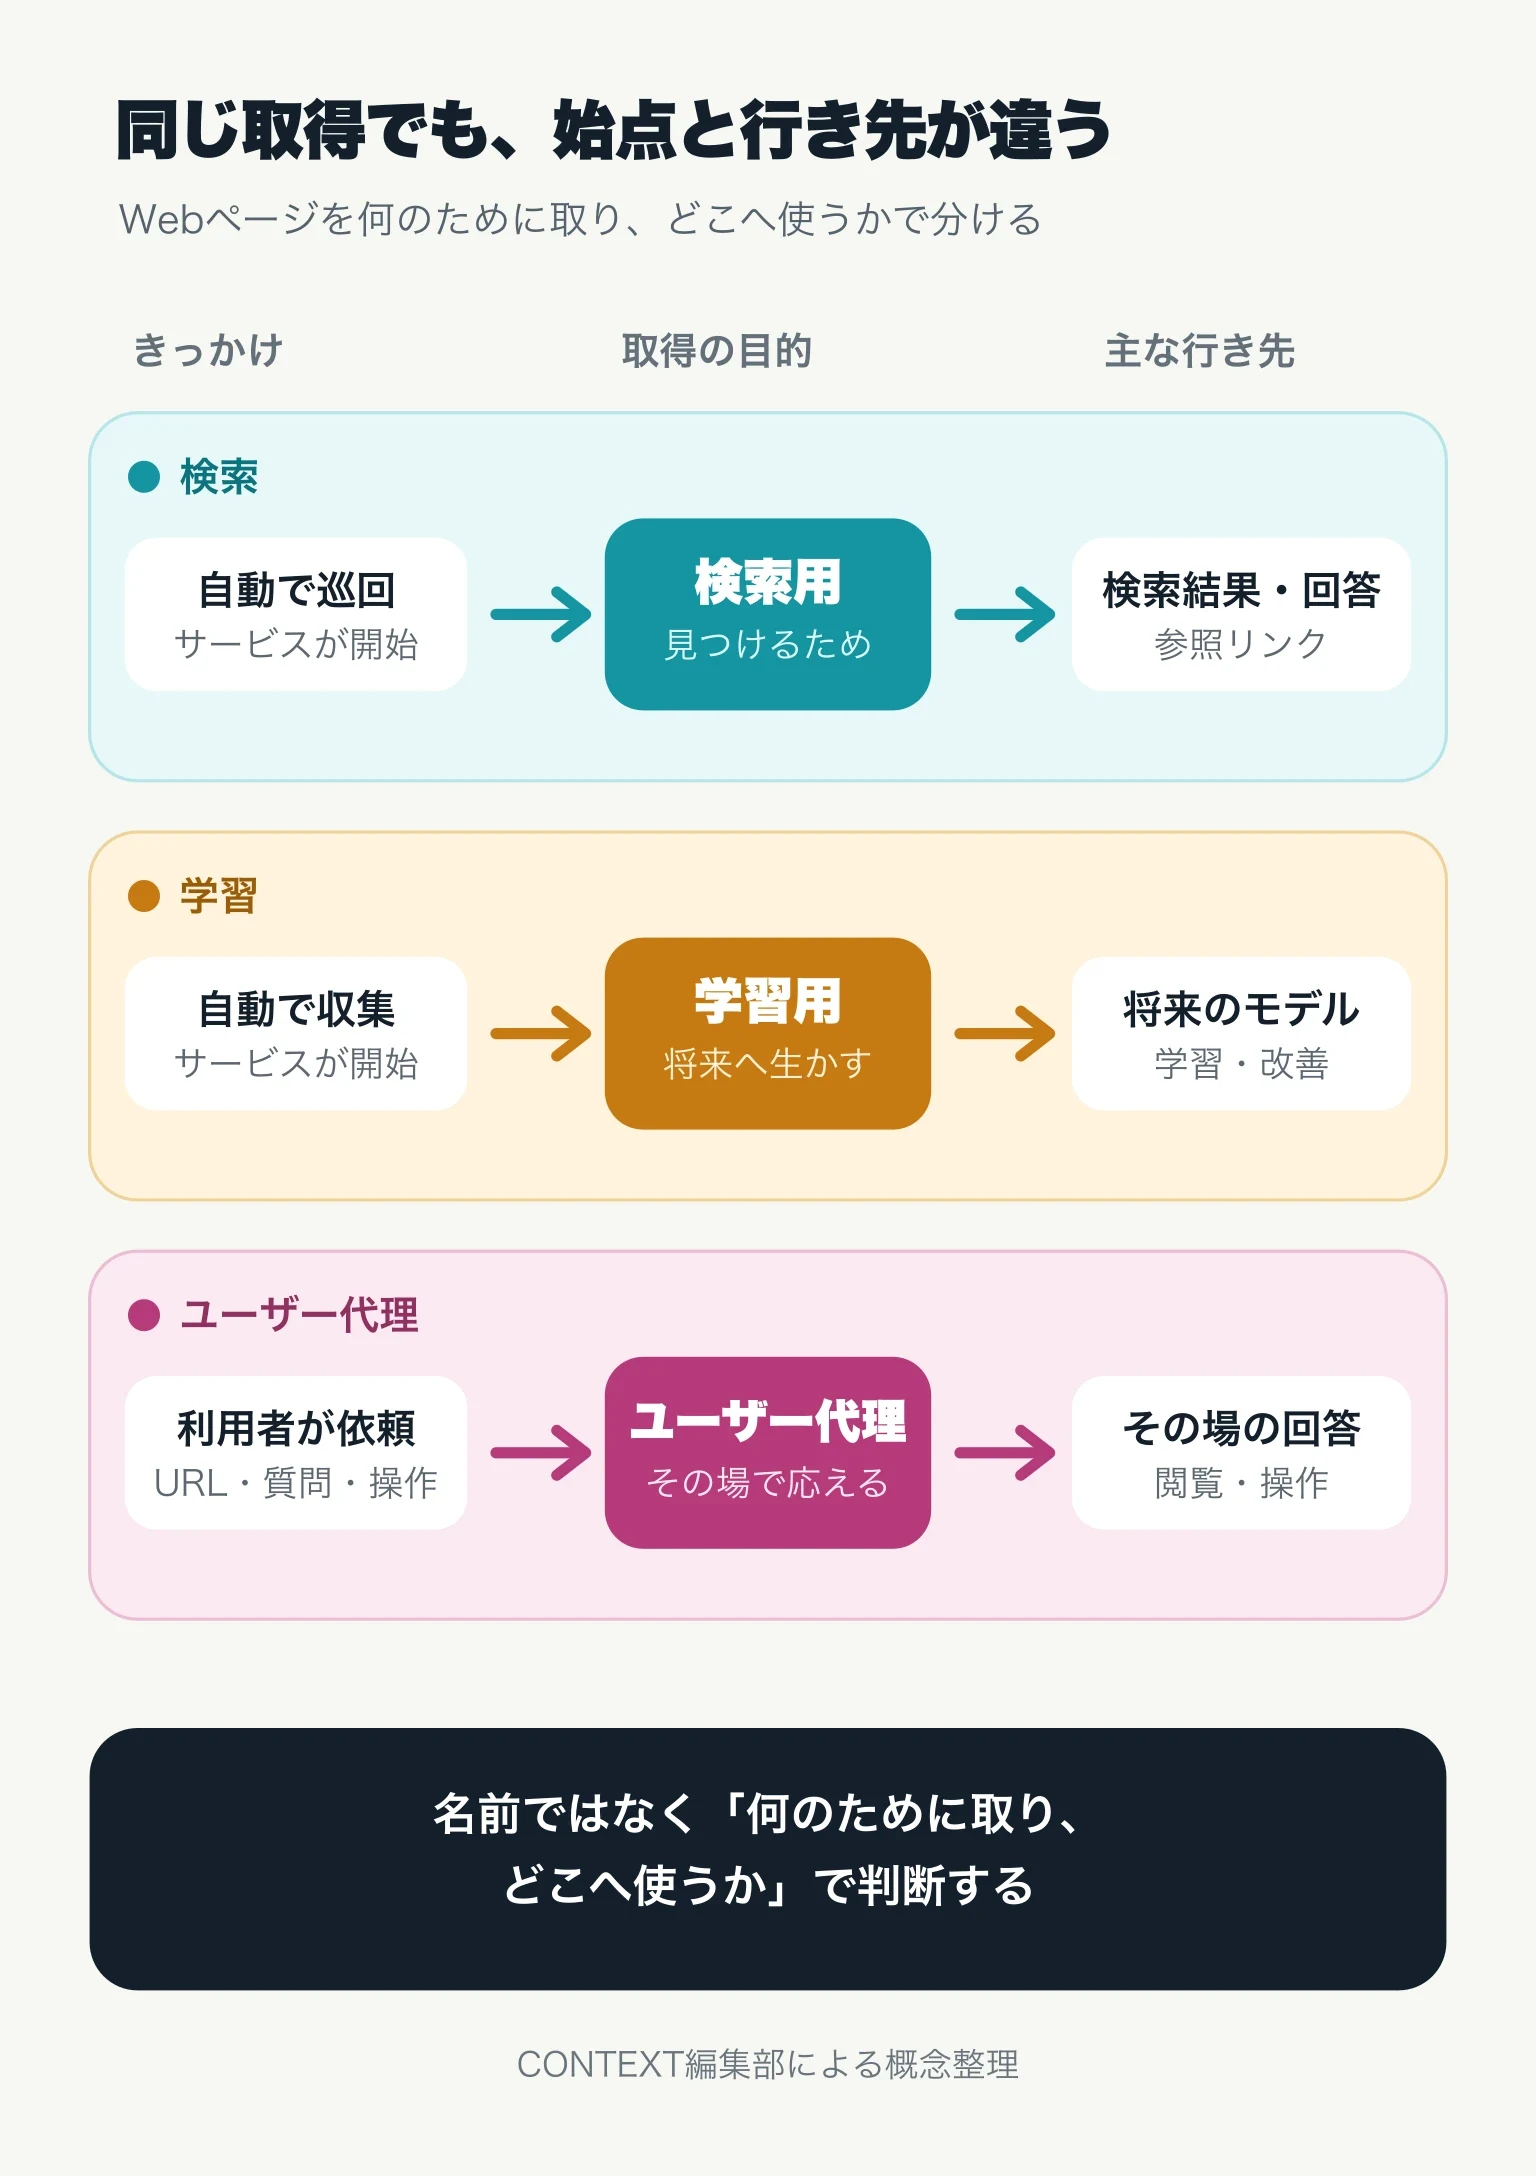
| 区分 | 主なきっかけ | 主な行き先 | 拒否後に考えること |
|---|---|---|---|
| 検索用 | サービス側の自動巡回 | 検索結果、回答、参照リンク | 自社情報が見つかりにくくなる可能性 |
| 学習用 | サービス側の自動収集 | 将来のモデル学習や改善 | 公開済みデータの扱い、反映時期、契約条件は別途確認が必要 |
| ユーザー代理 | 利用者がURL、質問、操作を指定 | その場の回答や処理 | 正当な利用者までページを取得できなくなる場合がある |
検索用を拒否した影響は、学習用を拒否した影響とは違う。OpenAIは、OAI-SearchBotを拒否したサイトはChatGPTの検索回答に表示されない一方、ナビゲーション目的のリンクとしては現れる場合があるとする。GPTBotの拒否は、コンテンツを学習に使わないよう示すものだ。[S1] Anthropicも、Claude-SearchBotを無効にすると利用者の検索結果における発見性や正確さが下がる可能性を説明している。[S4]
ユーザー代理については、robots.txtへの対応を一律に言えない。Googleのユーザー起動型fetcherの多くはrobots.txtを無視し、Google-AgentはGoogle上で動くエージェントが利用者の依頼でサイトへアクセスするときに使われる。[S3] OpenAIはChatGPT-Userについて、自動巡回ではないためrobots.txtが適用されない場合があると説明する。[S1] Perplexity-Userも一般にrobots.txtを無視する。[S5] その一方でAnthropicは、Claude-Userを含む公開済みのbotがrobots.txtとCrawl-delayに従うとしている。[S4] 『ユーザー代理は必ず無視する』とも『必ず従う』とも決めつけない。
また、拒否設定は過去の利用を自動で取り消す仕組みとは限らない。どの時点から、どのコンテンツに、何が適用されるかは、事業者の説明や契約を確認する必要がある。robots.txtの具体的な書き方と限界は別稿で扱い、本稿ではまず、発見性、学習、利用者アクセスのどれを変えたいのかを先に言葉にする。
名前だけでは、本物のbotだと確認できない
User-Agentは、アクセス元がHTTPリクエストで自称する文字列である。第三者が著名なbot名を名乗ることもできる。GoogleはUser-Agentが偽装され得るとして、公開IP範囲との照合や逆引き、正引きによる確認方法を案内している。[S2][S3] bot名が見えたことと、公式のクローラーだと確かめたことを同じ列にしない。
OpenAIはOAI-SearchBot、GPTBot、ChatGPT-Userごとの送信元IP一覧をJSONで公開する。[S1] PerplexityもPerplexityBotとPerplexity-UserのIP一覧を公開し、WAFで許可するならUser-Agentと送信元IPの両方を組み合わせるよう勧めている。[S5] Anthropicもbotの送信元IP一覧へのリンクを公式ページに掲載している。[S4] 一度控えた固定IPを永久に使わず、各社の公式エンドポイントを定期的に参照する。
- 時刻:タイムゾーンを含め、方針変更や負荷上昇と照合できる形にする
- 送信元:接続元IPと、公式IP範囲または正逆引きでの確認結果を分けて残す
- 名乗り:省略せずUser-Agent全文を保存し、公式名称との一致だけで本人確認済みにしない
- 取得先:URL、パス、HTTPメソッド、応答ステータス、送信量を記録する
- 判断:検索、学習、ユーザー代理、その他、未確認のどれとして扱ったかと根拠URLを残す
確認できないアクセスを直ちに悪意と断定する必要はないが、公式botとして特別扱いもしない。レート、対象パス、失敗率、送信量を見て、通常の不明な自動アクセスとして制限する。逆にUser-Agentだけを条件に全面許可すると、なりすましまで同じ扱いになる。識別と許可は別の判断である。
許可と拒否は、ページと目的を並べて決める
実務では『AIクローラーを許可するか』という一問を、ページ群と目的の表へ置き換える。会社概要、製品仕様、記事、調査資料、会員限定ページ、検索結果ページでは、見つけてほしい範囲も、再利用への考え方も、サーバー負荷も異なる。公開情報であっても、契約上の制約や第三者の権利が同じとは限らない。
- 発見性:このページ群をAI検索や通常検索から見つけてほしいか
- 学習利用:将来のモデル改善への利用について、権利者と自社の方針は何か
- 利用者代理:利用者が明示的に求めた閲覧や操作を通す必要があるか
- 運用負荷:クロール頻度、転送量、動的生成、認証境界へどの程度の負荷があるか
- 証拠:適用したbot名、送信元の確認方法、公式資料、決定者、見直し日を残したか
最初の棚卸しでは、全URLを一件ずつ判断しなくてよい。公開記事、製品情報、取引に必要なページ、ログイン内、管理画面、無限に生成されるURLという単位に分ける。それぞれについて、検索への掲載、学習利用、ユーザー代理の取得、負荷対策を別欄にする。判断できない欄は『未確認』とし、許可済みへ丸めない。
方針を実装した後は、公式説明の更新日と自社の見直し日を持つ。bot名、IP範囲、robots.txtへの対応、サービス上の影響は変わり得る。月次または四半期ごとに、不明なUser-Agent、拒否後の発見性、サーバー負荷、権利上の変更を確認し、判断の根拠を更新する。
AIクローラーを扱う要点は、会社名やUser-Agentを判断の最小単位にしないことである。何がきっかけでページを取り、取得後にどこへ使い、拒否すると誰に何が起きるのかを分ける。検索、学習、ユーザー代理、その他、未確認という欄を持てば、発見性を守りながら学習利用だけを制御する、正当な利用者アクセスを残しながら負荷を抑える、といった具体的な方針へ進める。
Sources / 参考資料