AI翻訳の文章を読んで、不自然な日本語が見当たらない。それでも、そのまま公開できるとは限らない。原文の `may` が「必ず」へ強まり、`unless` 以下の例外が落ち、製品名の後ろにあった版番号が消えていても、訳文だけを読めば滑らかに見えるからだ。
確認で見るべきなのは、日本語として読めるかだけではない。原文が伝えた主体、動作、否定、条件、数値、用語、強さが訳文に残っているかである。原文と訳文を対応する単位へ分け、意味の追加・欠落・変更を先に確かめ、その後で用語、読みやすさ、対象読者への適合を評価する。誤りの影響が大きい文は、語学力と分野知識を持つ人が原文へ戻って判断する。
本稿では欧州委員会の機械翻訳運用、米国政府の多言語サイト指針、翻訳品質評価のMultidimensional Quality Metrics(MQM)、機械翻訳評価の研究を基に、AI翻訳を「何となく自然」から公開判断へ進める確認手順を整理する。一般向け記事や製品情報を想定した実務整理であり、法令、契約、医療、安全に関する個別の専門判断を代替しない。
ここでいうAI翻訳には翻訳専用の機械翻訳と、大規模言語モデルへ翻訳を依頼する使い方を含める。仕組みや挙動は同じではなく、製品ごとの性能比較もしない。ただし、どちらの出力も公開判断では原文と用途へ戻って確かめる必要がある。
流暢さと正確さを同じ評価にしない
AI翻訳の確認は訳文だけを音読する工程から始めない。最初に原文と用途を固定し、「正確さ」と「流暢さ」を別々に見る。流暢さは対象言語として文法や表記が自然かという評価であり、正確さは原文の意味を追加・欠落・変更せずに運んでいるかという評価である。
MQMは翻訳品質を、Accuracy、Terminology、Linguistic conventions、Style、Locale conventions、Audience appropriateness、Design and markupという複数の次元で扱う。Accuracyには追加、誤訳、欠落などが含まれ、言語として整っているかとは分けられる。[3][4] 日本語が自然でも、原文にない効果を足したら正確さの問題である。原文どおりでも、顧客向け画面に研究者向けの用語を残せば、読者適合の問題が残る。
欧州委員会も自ら提供するeTranslationを「内容の概略を得る」「人間品質の翻訳の出発点」と位置づけ、完全な正確さと高品質が必要なら熟練した専門翻訳者の修正が必要だと説明する。[2] Europaサイトの機械翻訳では、文章や言語ペアによって品質と正確さが大きく変わり得ることを示し、EU法令には使わず、Eur-Lexの真正な24言語版を見るよう案内している。[1]
つまり、AI翻訳を一律に禁止するか、自然だから許可するかの二択ではない。用途ごとに必要な品質を先に決める。社内で概要をつかむ仮訳と、顧客が契約条件を判断する公開文では、同じ誤りでも影響が違う。公開文は、誰が何を決めるために読むかを翻訳仕様へ置く。
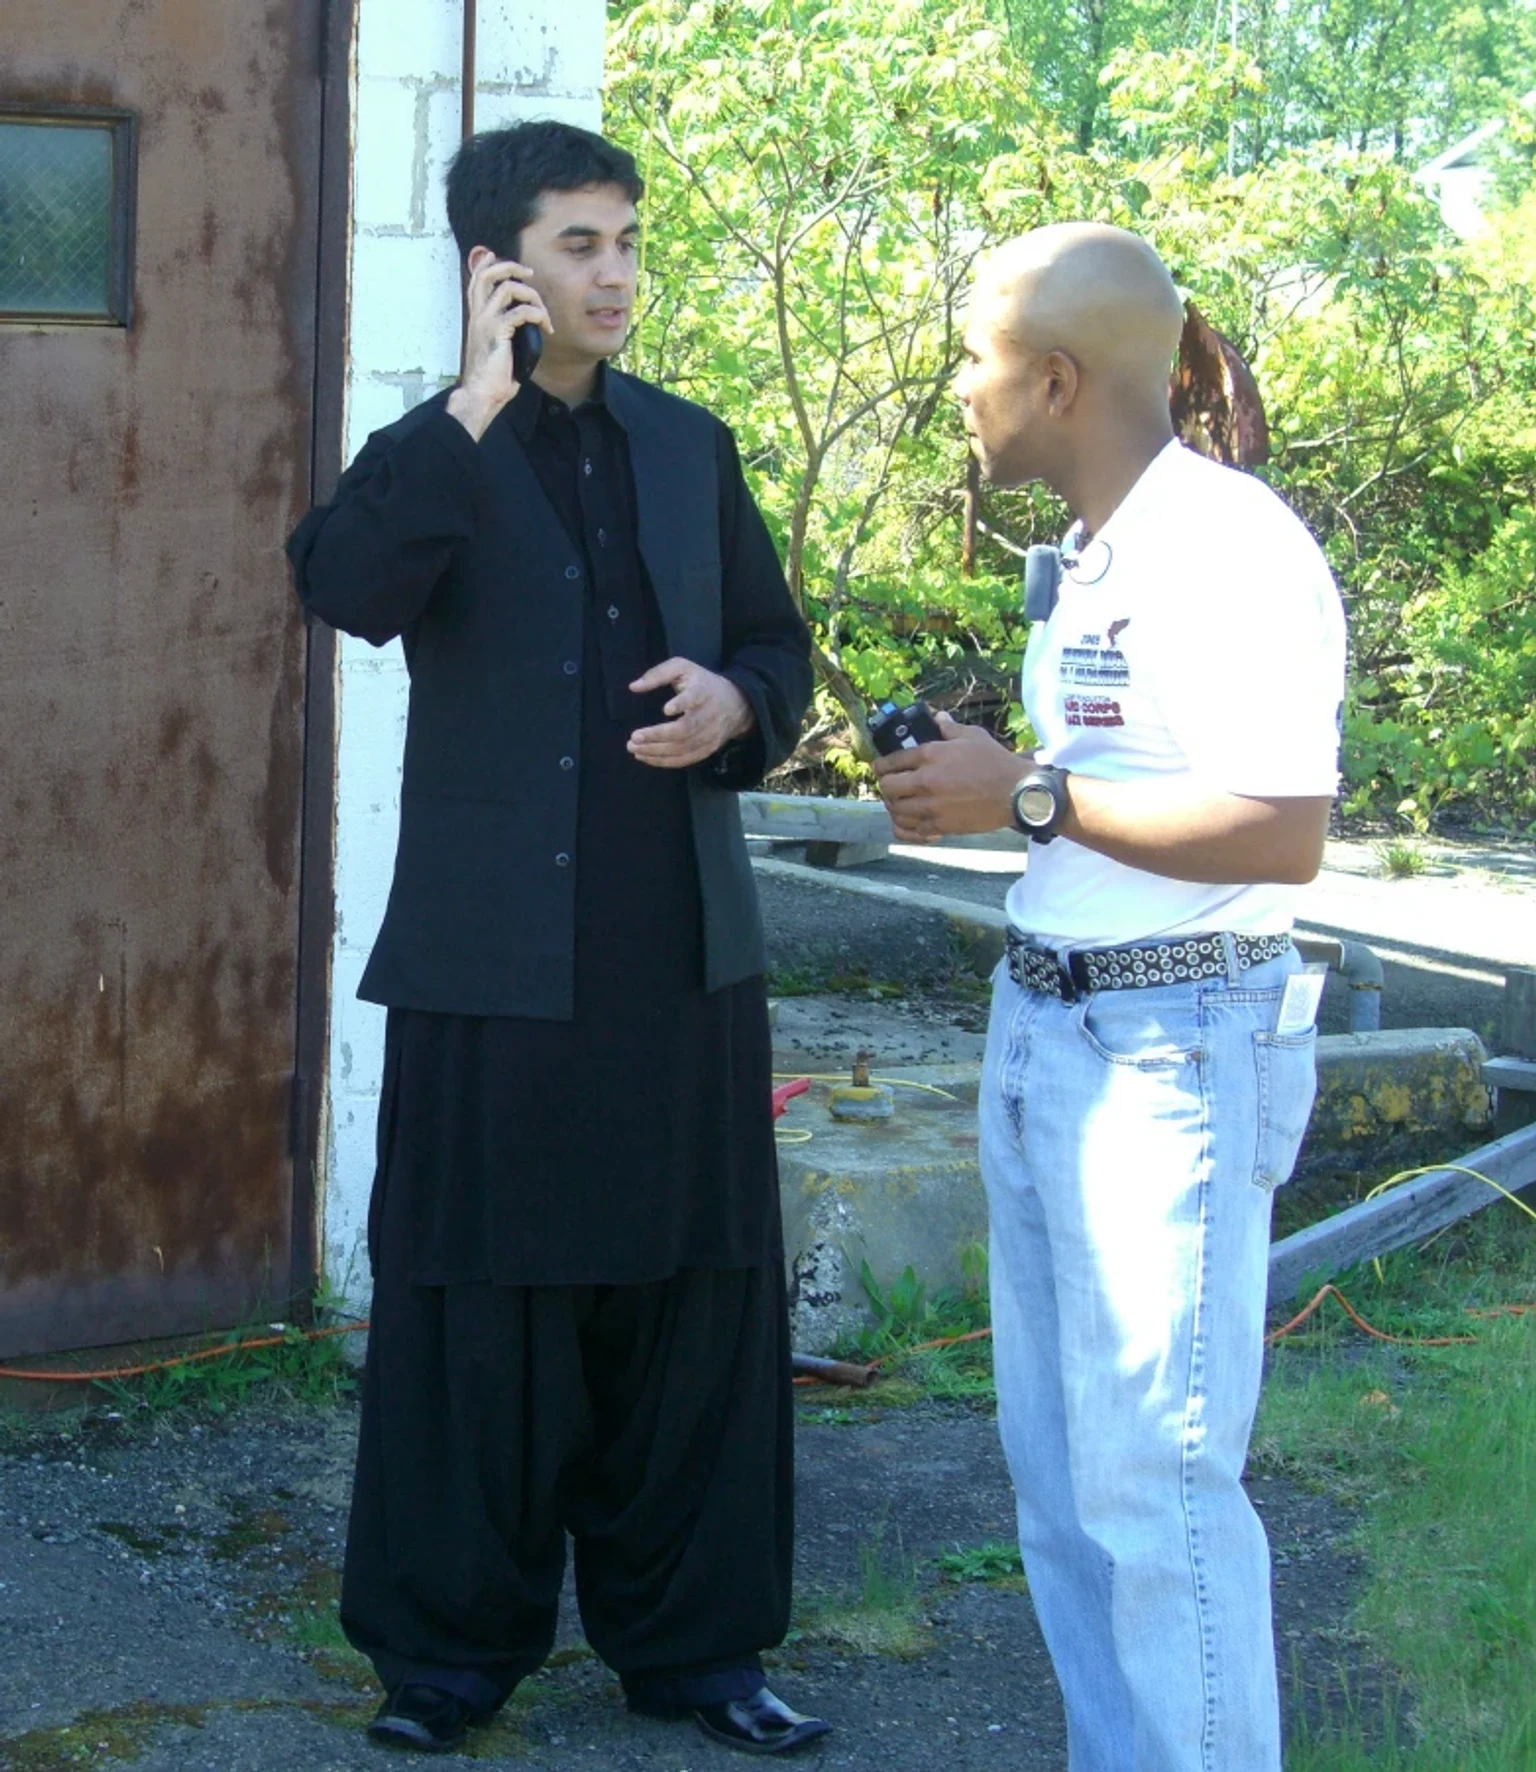
写真の試験は現在の生成AI翻訳の性能を示すものではない。ここで見るべきなのは、翻訳技術を使う場面、話者、目的を含めて評価している点である。NISTはこの写真を、国防総省向けの技術評価の一場面として公開している。[8]
先に、公開を止める情報を拾う
全文を頭から均等に直す前に、誤ると判断が変わる要素を拾う。企業の公開文なら、固有名詞、数値、単位、日付、否定、比較、条件、例外、義務・禁止、専門用語、参照先が優先である。これらは短い語でも、落ちると文章全体の結論を変える。
| 原文で印を付けるもの | 訳文で確かめること | 公開判断への影響 |
|---|---|---|
| 数値・単位・日付 | 桁、符号、小数点、通貨、時差、基準日が同じか | 価格、性能、期限を誤認させる |
| 否定・条件・例外 | not、unless、only、except、ifが残るか | できる/できない、対象範囲が逆転する |
| 義務・可能性 | must、should、may、canの強さが変わっていないか | 必須を任意に、可能性を確定に見せる |
| 固有名詞・用語 | 製品、制度、部品、役職を同じ概念で訳しているか | 検索・発注・問い合わせ先を誤る |
| 指示語・主語 | 誰が何をするか、前後の参照先が保たれるか | 責任主体や操作対象が入れ替わる |
この表は単語の一対一置換を求めるものではない。言語が変われば語順や表現は変わる。確認するのは、読者が受け取る判断条件が同じかである。たとえば `You may cancel unless shipment has started` を日本語へ移すとき、自然な語順へ組み替えても、「出荷開始後は取消不可」という例外を消してはならない。
米国政府の多言語ウェブサイト指針は、機械翻訳だけを解決策にすることを強く勧めず、利用する場合は公開前に有資格の言語専門家が確認し、意味を正しく、文化的にも適切に伝えているかを見るよう求める。[5] すべての文を同じ深さで人手確認するのではなく、まず用途と危険度で止める箇所を決めると、専門家へ渡す範囲も明確になる。
原文と訳文を、対応する単位で比べる
次に、原文と訳文を一文ずつではなく、意味のまとまりで対応させる。原文の一文が日本語で二文になることも、原文の二文を一文へまとめることもある。行数をそろえるより、主張、条件、根拠、例外がどこへ移ったかを追う。
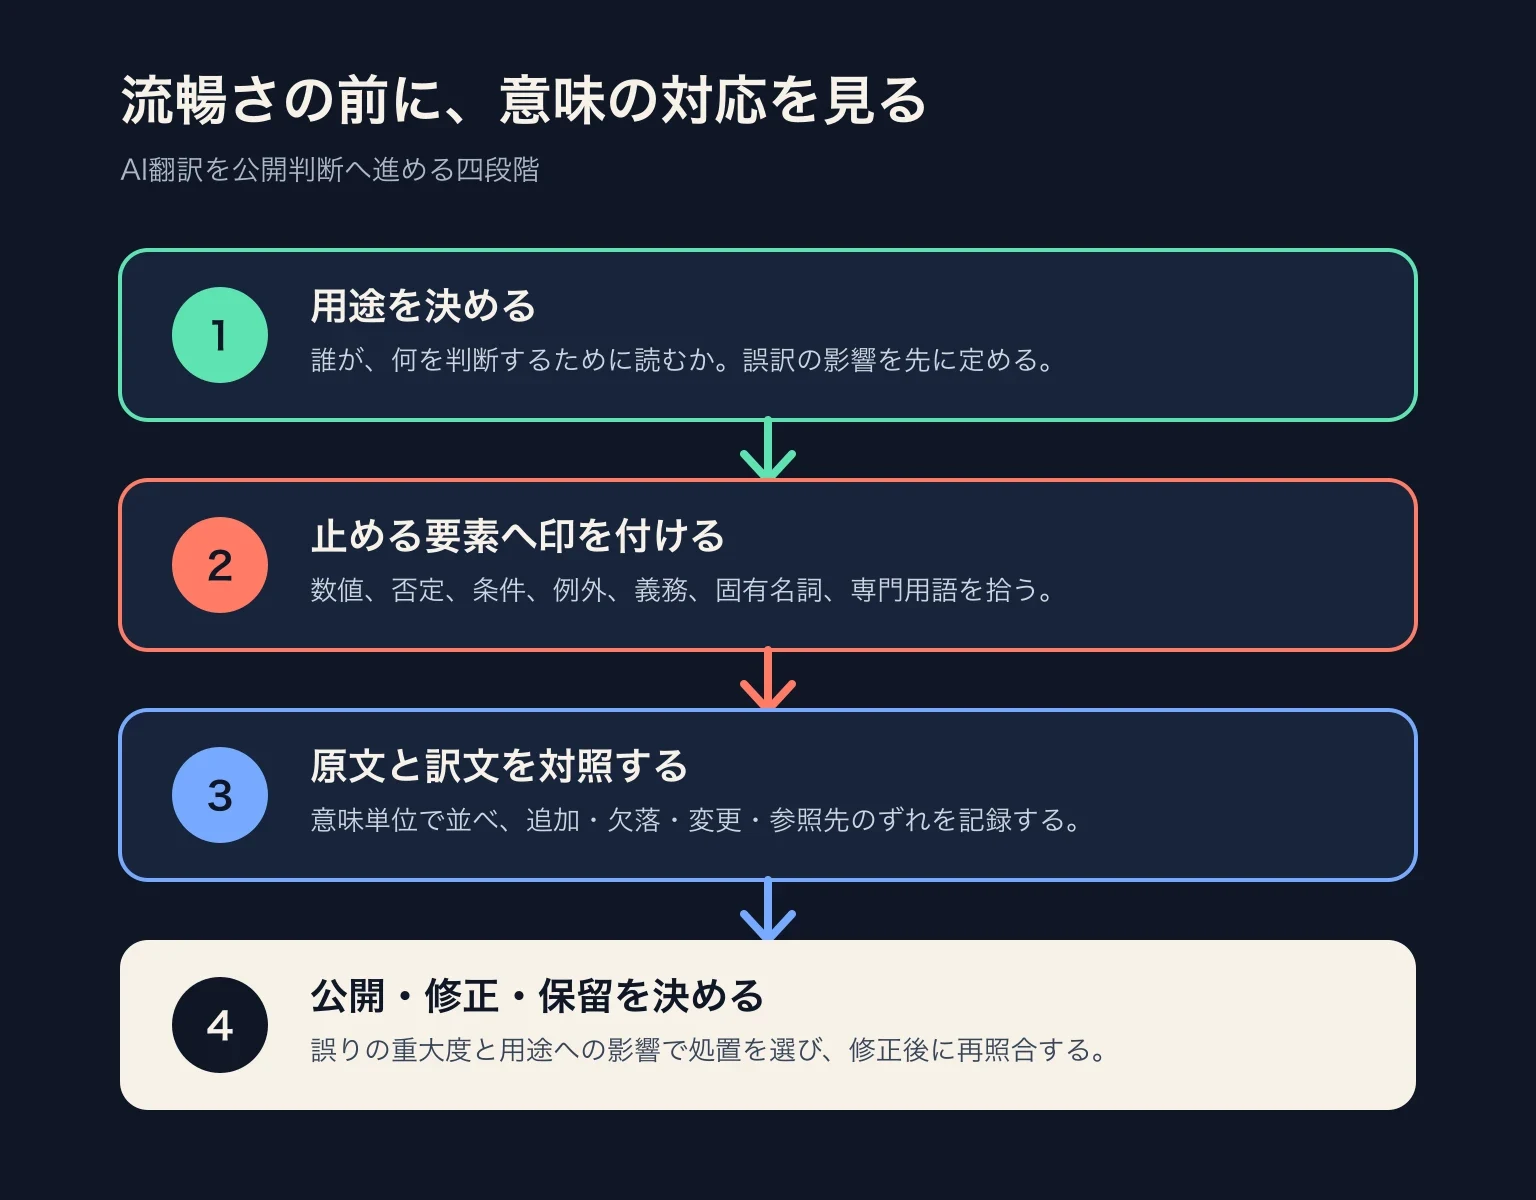
実務では次の順で一周する。
- 原文の版、作成者、対象読者、公開先を固定する。更新途中の原文を混ぜない。
- 原文で数値、固有名詞、否定、条件、例外、義務、専門用語へ印を付ける。
- 原文の意味単位と訳文を並べ、追加、欠落、変更、参照先のずれを記録する。
- 用語集、製品UI、法定名称、既存記事と照合し、同じ概念を同じ語で追えるようにする。
- 訳文だけを通読し、語順、文法、読みやすさ、対象読者、表示崩れを確認する。
- 誤りを直した後、変更した箇所を原文と再照合し、公開、修正継続、保留を決める。
文脈も切らない。2021年の大規模な人手評価研究では、専門翻訳者が文書全体の文脈を見てMQMで誤りを付けた結果、従来のクラウド評価者による順位とは大きく異なるシステム順位になった。[7] 研究結果を企業文書へそのまま一般化はできないが、一文だけでは代名詞、用語、語調の一貫性を判断しづらいことを示す材料になる。
同じ理由で、用語表だけでも足りない。`claim` が保険請求、特許請求項、広告上の主張のどれかは文書の分野で変わる。用語集には対訳だけでなく、定義、使う場面、使わない語、確認した原典を持たせる。技術用語を分かりやすく説明する記事で扱ったように、専門性を薄めることと、理解できる形へ翻訳することは別である。
原文に書かれた外部事実そのものを検証する工程も、翻訳の正確さとは分ける。原文と同じ意味に訳せていても、原文の主張が誤っていれば公開文も誤る。生成AIのファクトチェックで扱った「主張から根拠へ戻る確認」と、本稿の「原文から訳文へ意味が移ったかを見る確認」は、続けて実施する別の工程である。
逆翻訳と自動スコアを、合格判定にしない
逆翻訳や自動評価は、見直す候補を集める補助には使える。しかし、元の文に近く戻ったことや高いスコアだけで、公開可能とは判定しない。
逆翻訳では訳文を別の言語へ戻して大きな欠落を見つけられることがある。一方、同じ系統のモデルが最初の曖昧さを似た形で再解釈すれば、対象言語で不自然な用語や不適切な敬意表現があっても、原文らしい文へ戻る可能性がある。これは逆翻訳を無意味とする主張ではない。逆翻訳は差を探すテストであり、訳文の正しさを証明するものではないという編集上の位置づけである。
自動スコアにも同じ境界がある。2024年のEMNLP論文は、複数の自動評価指標が同じ原文に対する高品質な訳の微妙な差へ鈍感で、誤りゼロの訳を過大または過小評価することがあると報告した。[6] 指標は大量の候補を比較する研究・開発で役立つが、一つの公開文に重大な誤訳がないことの証明とは別である。
反対に、人が読めば必ず正しいとも限らない。原文を見ない日本語校正者は流暢さを直せても、意味の欠落を発見できない。分野を知らない二言語話者は用語の選択を誤ることがある。高リスク文では原文と対象言語を読める人、分野の意味を判断できる人、公開責任を持つ人の役割を分ける。生成AIコンテンツの人間レビューで整理した通り、「人が見た」という事実ではなく、誰が何を確認したかを残す。
誤り台帳を、次の翻訳仕様へ戻す
確認を一回の赤入れで終えると、次の原稿で同じ誤りが戻る。誤りごとに、原文箇所、訳文箇所、種類、重大度、修正、判断理由を残し、用語集、スタイルガイド、翻訳指示、テスト文へ戻す。
- 原文箇所:文書名、版、節、文番号
- 誤りの種類:追加、欠落、誤訳、用語、流暢さ、読者適合、表示
- 重大度:意味を変えて公開を止める/理解を妨げる/好みの修正
- 修正:何をどう直したか
- 判断理由:読者のどの判断へ影響するか
- 再発防止:用語集、禁止表現、例文、テストセットのどこへ戻したか
重大度は誤字の大きさではなく、用途への影響で決める。広告の句読点と、薬の投与条件から落ちた否定語を同じ一点として数えない。MQMでも、誤りの種類と重大度を組み合わせ、翻訳が仕様を満たすかを評価する。[4] 件数を減らすことより、公開を止める誤りを見逃さないことが先である。
AI翻訳の確認方法は自然な日本語へ整える作業だけではない。用途を決め、止める要素を拾い、原文と訳文を意味単位で比べ、誤りの影響に応じて公開・修正・保留を決める。逆翻訳、自動スコア、人のレビューは競合する方法ではなく、役割の違う道具である。
結論はリードと同じである。原文が伝えた主体、否定、条件、数値、用語、強さが残っているかを確かめ、影響の大きい文は二言語と分野を理解する人が原文へ戻って判断する。流暢さは入口であり、公開可否の証拠ではない。
Sources / 参考資料
2. European Commission:eTranslation
3. Association for Computational Linguistics:Multidimensional quality metrics: a flexible system for assessing translation quality
4. MQM Council:The MQM Error Typology
5. Digital.gov:Top 10 best practices for multilingual websites
6. Association for Computational Linguistics:Can Automatic Metrics Assess High-Quality Translations?
7. Association for Computational Linguistics:Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation
8. National Institute of Standards and Technology:Smart Phone Voice Translation System
9. National Institute of Standards and Technology:Copyrights & Disclaimers