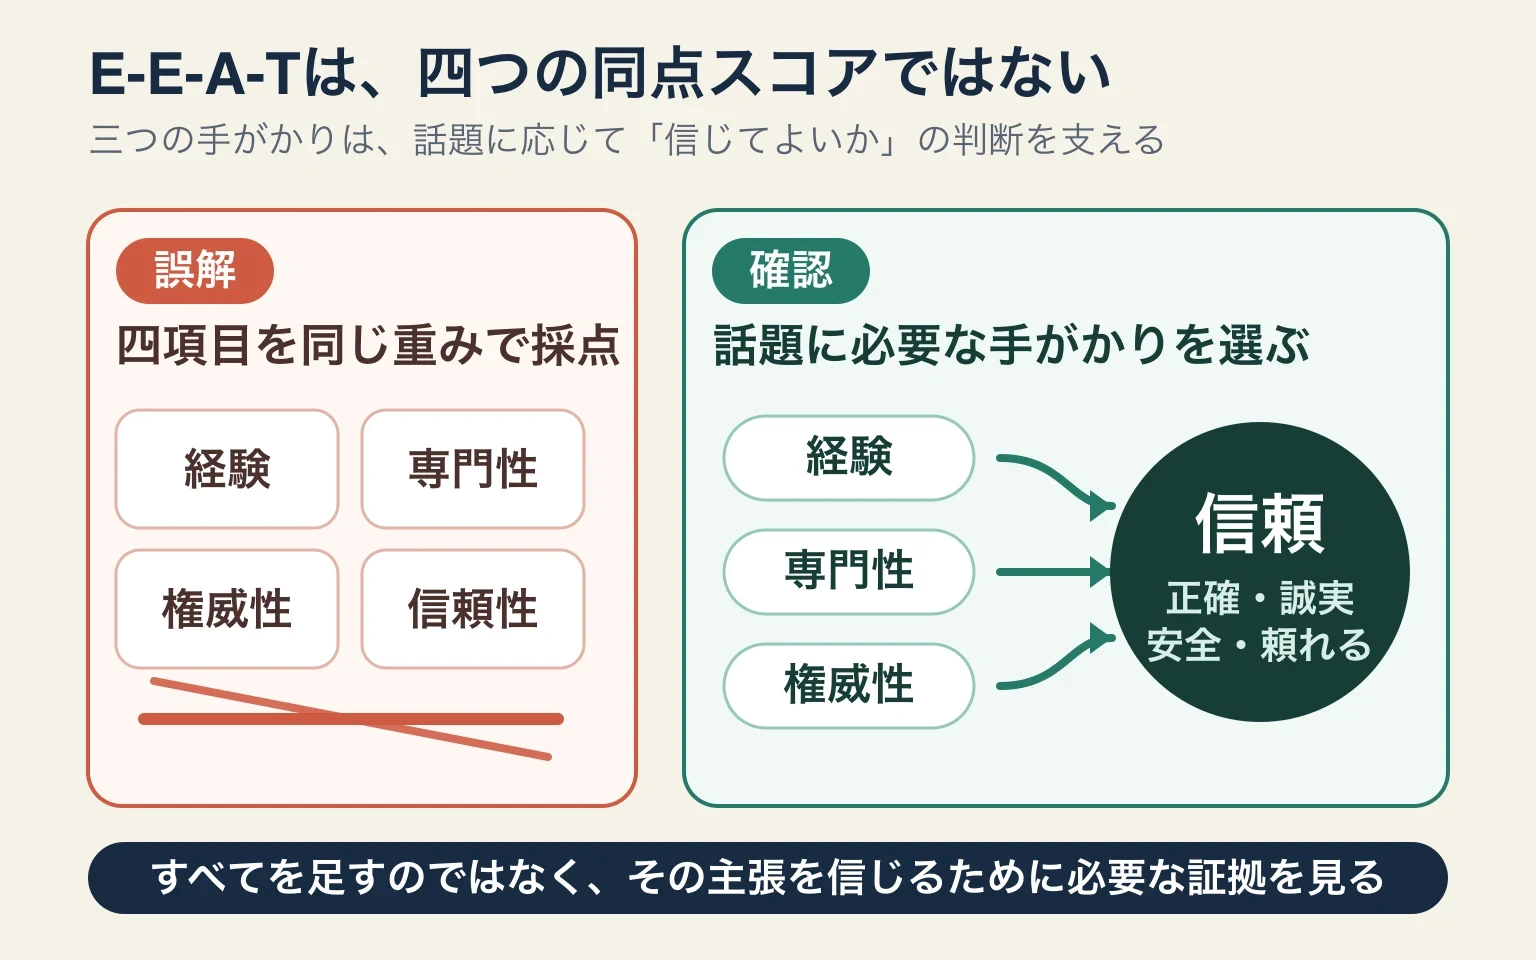
E-E-A-Tとは、ウェブ上の情報を信じてよいかを、Experience(経験)、Expertise(専門性)、Authoritativeness(権威性)、Trustworthiness(信頼性)から見る考え方である。四つの点数の合計で検索順位を決める採点表ではない。
会計ソフトの使い勝手を知るには、申告まで使った人の画面や手順が役立つ。一方、申告方法を決めるには、税務の専門知識と最新の公的資料が要る。同じ題材でも、信じるために必要な証拠は違う。
GoogleはTrustを最も重要とし、ほかの要素は信頼へ寄与するが、すべてを必須とはしない。E-E-A-T自体は特定のランキング要因ではなく、検索品質評価者の判断も個別ページの順位を直接変えない。[1][3]
本稿では、企業の一次情報をAI検索へ届ける方法とAI時代に文脈が重要になる理由を参照しながら、E-E-A-Tを主張ごとの証拠と責任へ落とす。
E-E-A-Tは、四つの点数ではなく「信じてよいか」を見る
E-E-A-Tの四語は、記事の外観を整えるチェック項目ではない。誰がどのような立場で語り、どんな方法と根拠で確かめ、読者へどの程度の危険を与え得るかを見るための手がかりである。Googleの公開文書では、経験、専門性、権威性がTrustを支える位置づけになっている。[1][3]
| 観点 | 見るもの | 証拠の例 |
|---|---|---|
| Experience(経験) | 商品を実際に使った、場所を訪れた、業務を行ったなどの一次経験 | 操作画面、撮影記録、条件付きの体験談 |
| Expertise(専門性) | その助言や判断に必要な知識と技能 | 資格、職務経験、研究、正確な説明と根拠 |
| Authoritativeness(権威性) | その話題で、著者・本文・サイトが参照先として認められているか | 外部からの評価、引用、分野内の実績 |
| Trustworthiness(信頼性) | ページが正確、誠実、安全で、頼れるか | 出典、責任主体、方法、訂正、利益関係の開示 |
Trustを中心に置くと、肩書だけで判断できない理由が見える。医師が書いた文章でも、参照した診療指針が古く、広告との関係を隠し、問い合わせ先もなければ、読者は安全に頼れない。反対に、資格を必要としない製品レビューでは、実際に使った条件、欠点、写真、比較方法を示す人の経験が大きな手がかりになる。
したがって「経験4点、専門性3点」のような共通スコアを作っても、GoogleのE-E-A-Tを測ったことにはならない。Googleは、E-E-A-T自体を特定のランキング要因とはしておらず、良いE-E-A-Tを見分けるのに役立つ複数の要因をシステムが使う、と説明している。[1]
検索品質評価者の指針は、検索システムが良い結果を返しているかを人が評価するための共通言語である。個々の評価者がサイトを採点して順位表へ入力するわけではない。Googleの概要資料も、一つの評価や一人の評価者が特定ページの順位へ直接影響しないと明記する。[3]
必要な経験と専門性は、話題と失敗時の影響で変わる
二つ目のEであるExperienceは、Googleが2022年に検索品質評価者向けの考え方へ加えた。実際に商品を使った、場所を訪れた、自分の体験を伝えた、といった一次経験を指す。Googleは、税の申告方法には会計の専門家が望ましい一方、税務ソフトのレビューでは利用経験者の話が役立つという対比を示している。[2]
ここから分かるのは、ExperienceとExpertiseの優劣ではない。検索した人が何を決めようとしているかによって、必要な手がかりが変わるということだ。飲食店の混雑や席の広さは訪問経験が強い。食物アレルギーの安全判断は、店の公式情報、成分、専門的な助言を優先する。
| 問い | 重く見るもの | 必要な証拠 |
|---|---|---|
| このカメラを一日持ち歩くと重いか | Experience | 使用者、機材構成、時間、身体条件、持ち方 |
| この治療は安全か | ExpertiseとTrust | 公的指針、研究、専門家の確認、対象外条件、更新日 |
| この企業の売上はいくらか | AuthoritativenessとTrust | 決算資料、対象期間、単位、訂正履歴 |
| このサービスは初心者でも使えるか | ExperienceとTrust | 試した課題、参加者の前提、失敗例、提供側との利害 |
健康、金融、安全、社会の福祉に大きく影響し得る話題は、GoogleがYMYL(Your Money or Your Life)と呼ぶ領域で、より高い品質基準が必要になる。誤りの結果が「少し不便」なのか、「健康や資産を損なう」なのかを先に考えると、専門家レビューや公的根拠をどこまで求めるか決めやすい。[1][3]
逆に、すべての記事へ資格者の監修を付ければよいわけではない。会社員の転職体験、介護する家族の生活、製品を使い続けた感覚には、当事者しか持たない一次経験がある。ただし個人の経験を一般的な医療・法律・投資判断へ広げるときは、適用範囲と専門的根拠を分ける必要がある。
著者紹介より先に、主張ごとの証拠をつなぐ
E-E-A-T対策として、著者名、顔写真、資格、会社概要を追加することはある。責任主体を見えるようにする点では大切だが、それだけでは本文の主張を確かめられない。「専門家監修」と書かれていても、誰が、どの箇所を、いつ、何に基づいて確認したか不明なら、読者が検証できる範囲は狭い。
Googleが自己点検に勧めるWho、How、Whyは、署名を本文の証拠へつなぐ考え方になる。Whoでは、誰が書いたか、署名から著者の背景と扱う分野へ進めるかを見る。名前だけでなく、その主張と著者の経験・専門性の関係が必要である。[1]
Howでは、どう作ったかを示す。製品比較なら試した台数、期間、環境、評価方法、写真が手がかりになる。調査記事なら、資料の範囲、取材人数、集計方法、確認できなかった点を残す。AIや自動化を大きく使った場合も、読者が作成方法を疑問に思う内容なら、役割を説明することが文脈になる。[1][4]
Whyでは、何のために作ったかを見る。検索流入を集めることだけを目的に、読者がすでに読める説明を大量に言い換えても、独自の価値は増えない。読者がどの判断をできるようになる記事か、そのために自社が持つ一次情報や取材を何に使うかを企画段階で決める。[1]
| 表示だけ | 接続した状態 |
|---|---|
| 専門家が監修 | 監修者名、関連分野、確認範囲、確認日、参照した基準を示す |
| 実体験に基づく | 誰が、いつ、どの条件で、何回試し、何を比較できなかったか示す |
| 公式情報を参照 | 資料名、発行者、対象期間、該当箇所、アクセス日を示す |
| 最新情報へ更新 | 変えた主張、根拠、変更日、旧情報が誤りだったかを残す |
実務では、記事全体へ一つのE-E-A-T点を付ける代わりに、「主張台帳」を作る。まず、読者の判断を変える主張だけを選ぶ。定義、数値、比較、助言、引用、将来予測などである。次に各主張へ、証拠、確認者、確認日、適用範囲、反対条件を結ぶ。
- 主張:読者が事実や助言として受け取る一文
- 必要な観点:経験、専門性、権威性のうち、その主張を信じるために必要なもの
- 証拠:一次資料、取材、実測、画面、写真、専門家確認など
- 責任者:執筆、検証、監修、最終判断をした人
- 範囲:いつ、どこで、誰に、どの条件まで当てはまるか
- 更新条件:制度変更、新版、価格改定、訂正連絡など、再確認を始めるきっかけ
Authoritativenessは、自称で完成しない。自社が「業界を代表する」と書くことと、独立した組織や専門家がその分野の参照先として扱うことは違う。無関係な受賞歴や取引先ロゴを記事へ並べるより、主張に近い実績、第三者からの引用、一次資料への責任あるリンクを示す。
Trustは公開後にも作られる。誤りを連絡できる窓口、修正内容が分かる更新履歴、利益関係や広告の明示、古くなった主張の再確認を運用へ入れる。間違えないと装うより、間違いを発見し、直し、読者へ伝えられるほうが、媒体として責任を示せる。
AIを使ったかより、誰が何を確かめたかを残す
AIで生成した文章だから自動的に低品質になる、あるいはAIを使わなければE-E-A-Tを満たす、という線引きはできない。Googleは、生成方法ではなく、正確さ、品質、関連性を重視し、生成AIを調査や独自コンテンツの構成に使えると案内している。[4]
問題は、人が最終ボタンを押したかではなく、重要な主張を誰がどの証拠で確かめたかである。AIが要約した公的資料なら原文へ戻る。引用、日付、固有名詞、数値、比較条件を照合し、分からないことを埋めない。生成物へ人の名前を置くだけでは、確認工程の代わりにならない。
作成方法の開示も一律の定型文ではない。Googleは、読者が「どう作ったのか」と疑問に思う内容では、AIや自動化の使い方を説明すると文脈を与えられるとしている。比較データの生成、画像の作成、翻訳、要約など、読者の評価に影響する役割を具体的に書く。[1][4]
AI検索向けにE-E-A-Tの専用タグや特別なschemaを追加する必要もない。GoogleはAI OverviewsやAI Modeへの表示に追加の技術要件はなく、専用の構造化データも不要だと説明する。2026年の公式ガイドでも、AI向けに本文を細切れにすることや、専用の書き方へ変えることを要件としていない。通常の検索と同じく、クロール可能な本文、内部リンク、可視内容と一致する構造化データ、利用者に役立つ独自情報が基本になる。[5][7]
一方、検索順位を操作する目的で、価値を足さないページを大量生成することは、scaled content abuseに当たり得る。Googleのスパムポリシーは、生成AIに限らず、検索順位の操作を主目的に、独自価値の乏しいページを大量に作る行為を対象にする。[6]
- 記事の目的と、読み終えた人ができるようになる判断を一文で言えるか
- 読者の判断を変える定義、数値、比較、助言、引用を抽出したか
- 各主張に必要なのは一次経験か、専門知識か、公的資料かを分けたか
- 誰が書き、誰が何を確認し、どこまで責任を持つか見えるか
- 取材、実験、集計、AI利用など、作成方法を必要な範囲で説明したか
- 適用外の条件、不明点、利益関係、更新日、訂正方法を隠していないか
- 読者が画面上のリンクや資料から、重要な主張をたどり直せるか
| 種類 | 指標の例 | 分かること |
|---|---|---|
| 運用品質 | 重要主張の根拠付与率、確認者と確認日の記録率、期限切れ主張数、訂正までの時間 | 編集工程を実行できたか |
| 読者行動 | 出典リンク利用、読了、再訪、問い合わせ、保存や共有 | 記事が判断に使われた可能性 |
| 検索成果 | 対象クエリの表示、クリック、掲載ページ、指名検索 | 検索上の変化。ただしE-E-A-Tだけの因果は示せない |
Search ConsoleにはE-E-A-Tの点数が表示されない。著者ページを追加した日と検索流入が増えた日が近くても、順位更新、競合、季節、タイトル、内部リンクなど別の要因がある。変更内容と日付を記録し、対象ページとクエリを追うことはできるが、単一施策の効果として断定しない。
E-E-A-Tは、検索エンジンに見せる肩書の一覧ではなく、読者が「この一文を信じてよいか」を確かめられる状態を作るための確認軸である。経験、専門性、権威性を全部同じ重さで足すのではなく、話題と危険度に必要な証拠を選び、Trustへつなぐ。AI検索の時代にも、誰が、どう作り、何を根拠にし、間違いをどう直すかという責任は変わらない。
Sources / 参考資料
2. Google Search Central:Our latest update to the quality rater guidelines: E-A-T gets an extra E for Experience
3. Google:Search Quality Rater Guidelines: An Overview
4. Google Search Central:Google Search's guidance on using generative AI content on your website
5. Google Search Central:AI features and your website
6. Google Search Central:Spam policies for Google web search
7. Google Search Central:Optimizing your website for generative AI features on Google Search