会議の前にAIペルソナへ商品案を見せる。数分後には、何百人分もの反応が並ぶ。速い。だが、その数字を「顧客の声」と呼んでよいのだろうか。
Pew Research Centerは2026年9月30日、実在する調査参加者の属性や過去の回答をAIへ与え、その人のように答えさせる「デジタルツイン」を、人間本人の回答と比較した結果を公表した。3回、約300の設問で生じた割合の差は、平均約12ポイントだった。1
この記事では、合成回答者を一律に否定しない。現在の人間を「測る」道具と、仮説を「試す」道具を分ける。 その境界を、Pewの実測と日本の議論から整理する。
Pewは「同じ人のAI版」に同じ質問をした
合成回答者とは、生成AIに年齢、性別、居住地、政治的傾向などのプロフィールを与え、人間の代わりに質問へ答えさせたものだ。Pewの実験では、確率標本を基盤にしたAmerican Trends Panelの参加者一人ひとりに対応する「デジタルツイン」を作った。2
AIには、本人の人口統計情報だけでなく、Pewが別の調査から構築した政治類型なども与えた。質問と選択肢は、人間へ提示したものと同じ順番にした。合成回答にも人間側と同じウェイトを適用した。単純な「平均的な米国人」を一人作ったのではなく、同じ構成の集団を再現しようとした設計である。2
それでも、2025年から2026年の3回、約300設問を比べると、人間と合成回答者の回答割合の絶対差は平均約12ポイントだった。15ポイントを超える差が出た設問は約28%に達した。黒人成人、ヒスパニック成人、共和党支持・共和党寄りの回答では、全体より差が大きかった。1
これは、個人の答えが「12ポイント間違った」という意味ではない。各選択肢を選んだ集団の割合を比べ、その差の絶対値を平均した数字だ。また、米国成人、3回の調査、特定のモデルと生成手順の結果である。すべてのAIペルソナ、国、テーマで同じ差が出ると一般化はできない。
一方で、この条件の限定こそ重要だ。合成回答は、対象者の属性だけで決まらない。モデル、プロンプト、生成日、推論設定、学習済み情報によって変わる。人間の回答を観測した値ではなく、設定されたモデルが、その人なら選びそうだと予測した値なのである。
ずれは「確信」「現在」「回答の幅」で広がった
第一のずれは、AIが「わからない」と言いにくいことだった。人間が「わからない」「確信がない」に相当する選択肢を選んだ割合は16%。合成回答者は4%だった。知識問題の正答率も、人間の約50%に対して合成回答者は約80%だった。1
たとえば、言論の自由などを保障するのが米国憲法修正第1条だと答えた割合は、人間52%、合成回答者98%。NATOの主な目的を正しく選んだ割合は56%対99%だった。1 AIは人間より物知りな「回答者」を作り、実際の生活者が迷う幅を縮めた。
第二は、直近の変化である。2026年1月から4月にかけて、トランプ大統領を支持すると答えた人間は37%から34%へ減った。合成回答者は、両時点を46%とした。3
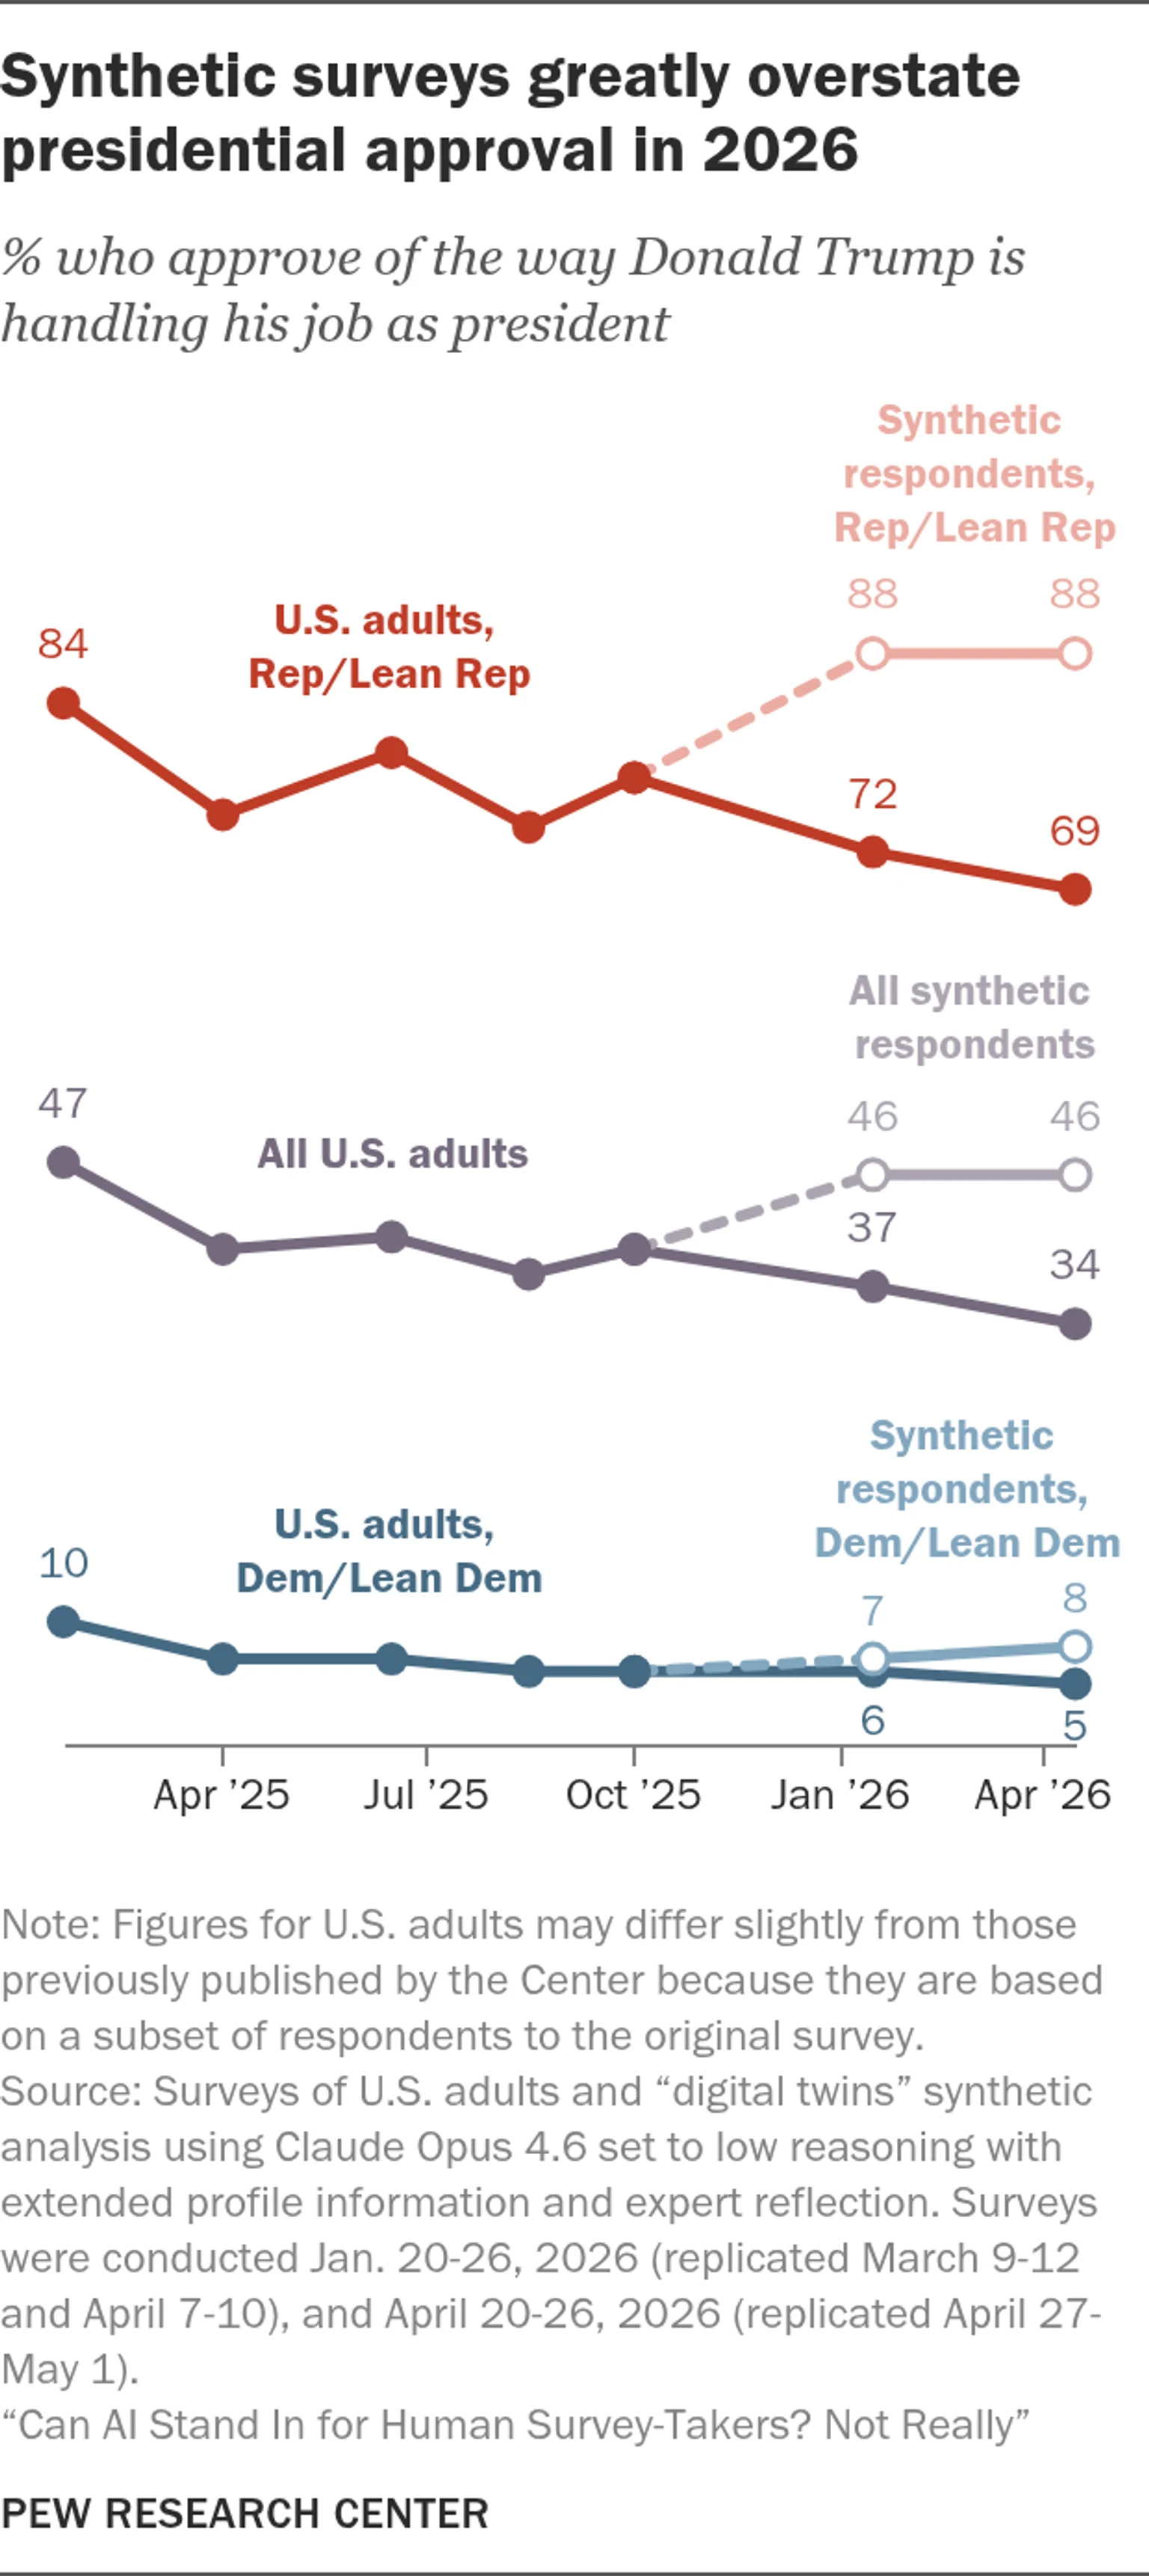
図版の元資料:Pew Research Center「Synthetic surveys and timely and topical questions」
第三は、回答の幅である。データセンターについて「よく聞いた」と答えた人間は25%、「少し聞いた」は49%、「まったく聞いていない」は26%だった。合成回答者は3%、94%、3%。一見近い「少し聞いた」へ極端に集中した。3
影響評価でも、合成回答者は生活の質、住宅のエネルギー費、環境への悪影響を97〜99%と予測した。人間は41〜53%だった。反対に、雇用と地域の税収への悪影響は合成回答者が0%、人間は20%と17%だった。3 AIは一貫した物語を作ったが、人間の迷いと矛盾を残せなかった。
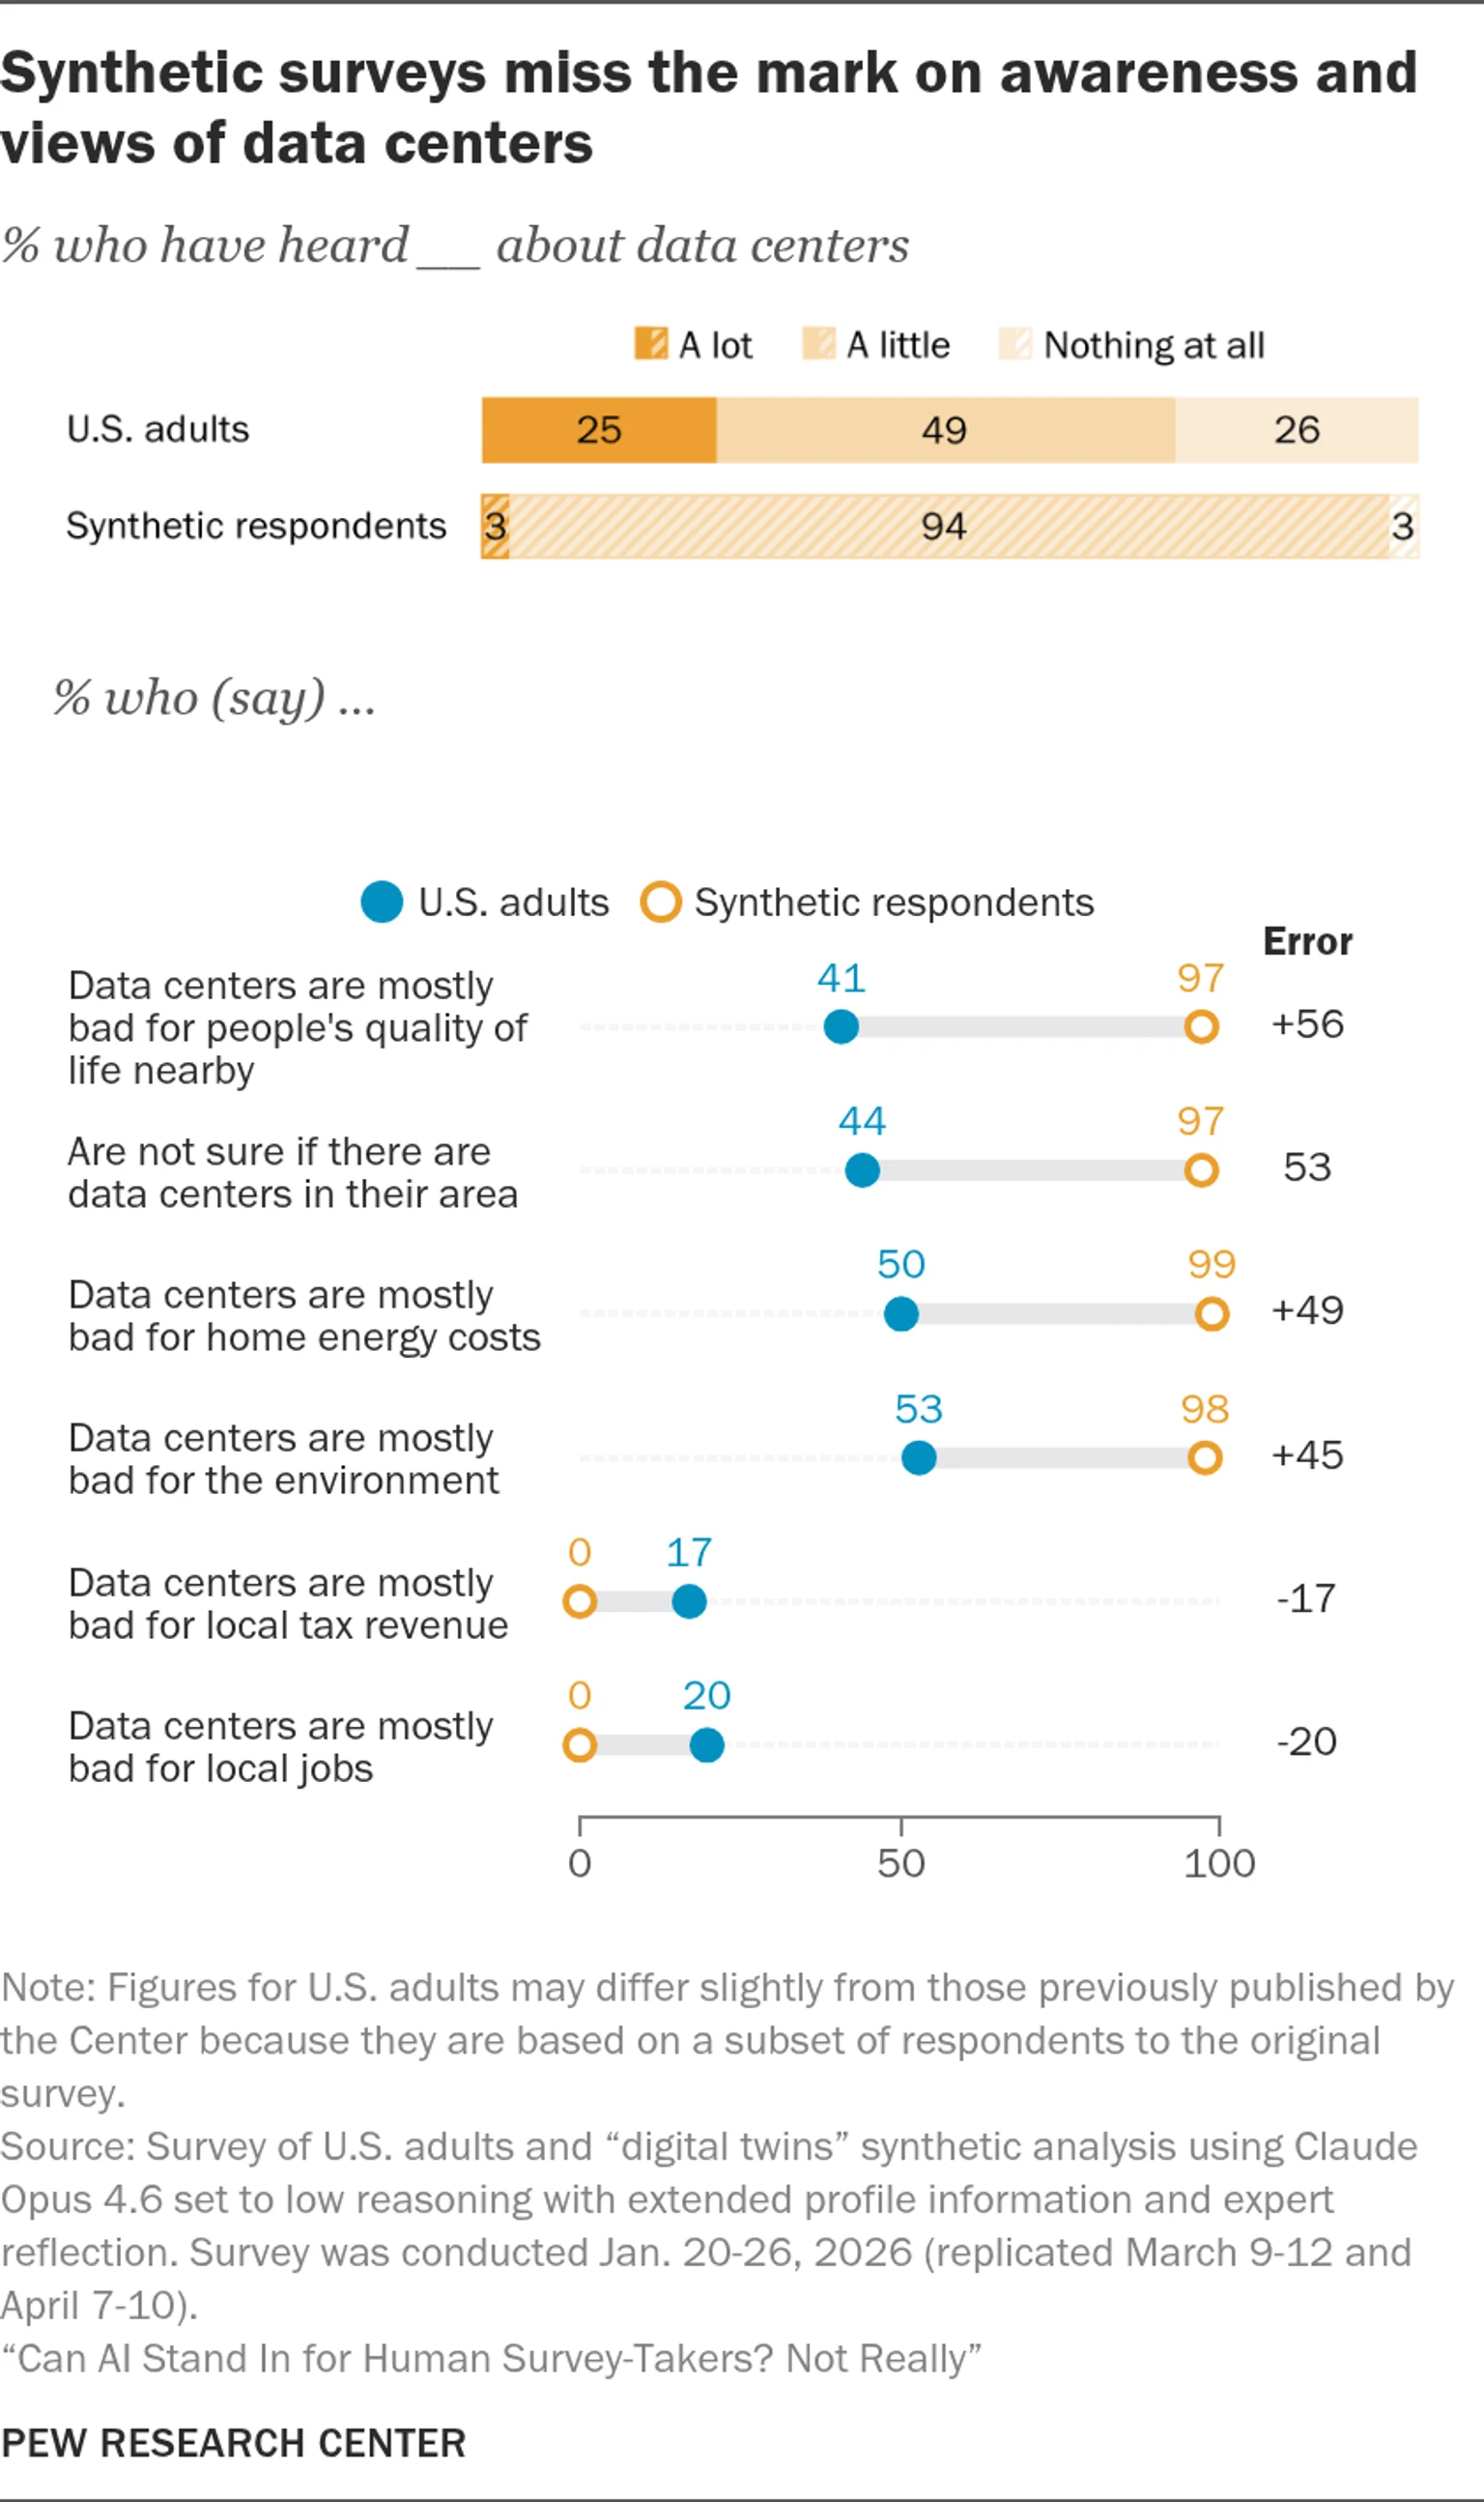
図版の元資料:Pew Research Center「Synthetic surveys and timely and topical questions」
モデルを替えても、問題は消えなかった。同じ約6,700人のプロフィールへ同じ質問をした比較では、Claude Opus 4.6の平均絶対誤差は11.4ポイント、GPT-5.1は13.3ポイントだった。GPTは極端な選択肢、Claudeは中間の選択肢へ寄る傾向があった。4
「精度の高いモデルを一つ選べばよい」という話ではない。同じ調査票と同じ人の属性でも、モデル選択だけで集団の性格が変わる。合成回答から市場の割合を示すなら、モデル名と生成条件を隠すことは、標本設計を隠すことに近い。
これは一つの新しい調査だけの指摘でもない。Bisbeeらの査読研究は、LLMの回答が集団平均では人間に近づく場合でも、回答のばらつきや変数同士の関係は異なり、わずかなプロンプト変更や生成時期でも結果が動くと報告した。7 「平均が合った」ことだけで、人間集団を再現できたとは判断できない。
日本では「測定」と「予行演習」を分ける
日本でも、AIへ生活者の属性や価値観を与え、市場調査や政策形成に使う議論が進む。NIRA総合研究開発機構は2026年6月、「AI仮想市民」をテーマに5人の識者の見解をまとめた。6
積極論は、大量の仮説を低コストで試せる点を見る。慎重論は、LLMの出力が均一になりやすく、多様性や突発的な変化、その時代の空気を再現しにくい点を見る。両者に共通するのは、完全な人間の置き換えではなく、目的を限って使うという考え方だった。6
米国世論調査協会(AAPOR)も、AI生成回答を人間の調査参加者と明確に区別し、生成方法を開示するよう求めている。5 これは表示の問題に見えるが、判断の問題でもある。「AIが予測した顧客の48%」と「抽出・募集した人間の48%」では、数字の作られ方も、反証する方法も違う。
用途は、次のように分けられる。
| 工程 | AIの役割 | 人間の確認 |
|---|---|---|
| 調査票の事前テスト | 分岐の破綻、重複、選択肢不足の仮説を出す | 少人数の認知インタビューで解釈を確認 |
| 初期コンセプト比較 | 反対理由や想定外の論点を広く列挙する | 実顧客で優先順位と割合を確認 |
| 直近の感情・認知 | 過去情報から仮説を作るまで | 新しい出来事の後は実際の人へ聞く |
| 高額投資・対外公表 | シナリオ比較の補助 | 標本、募集、回答率、誤差を示せる調査で判断 |
この表は、合成回答を「安いアンケート」にしないための境界である。AIで1000件を生成しても、1000人が回答したことにはならない。速さは標本数へ読み替えず、探索できた仮説の数として評価する。
CONTEXTでは以前、AI評価者を社内へ組み込む動きを扱った。評価を速く回すことと、評価基準を誰が決め、どこで人が止めるかは別の問題だった。合成回答者も同じで、生成を自動化するほど、測定の責任は人間側へ戻る。
また、DoorDashの広告効果を第三者が監査する仕組みが示したように、数字は作るだけでなく、比較条件を検証できなければならない。合成回答の精度を示すなら、都合のよい事例ではなく、同時期の人間データを基準に誤差を出す必要がある。
顧客調査を設計する人が持ち帰る3つの学び
1. AIの答えは「観測値」ではなく「予測値」と表示する
ダッシュボードや報告書では、AI生成と人間回答を色だけで混ぜない。AI生成であること、モデル名、生成日、主要なプロンプト、与えた属性、人間データで検証した誤差を、数字の近くへ表示する。
「調査」「回答者」「N数」という言葉も、人間データと誤認させない。AIが作った1000件は、1000人の経験や意思ではない。AAPORの基準が求める区別は、注釈ではなく見出しから行う。5
2. 新しい出来事ほど、実際の人へ聞く
価格改定、炎上、競合の新商品、制度変更、災害の後は、過去のパターンより現在の経験が効く。Pewの支持率とデータセンターの例は、プロフィールが詳しくても、変化の直後を自動で観測できないことを示した。3
合成回答で先に質問候補を絞ることはできる。だが、「いま何を知っているか」「いま何に困っているか」「いま買うか」を割合として示す前に、対象となる人へ聞き直す。更新頻度の高いテーマほど、人間調査の間隔を短くする。
3. AIで先に壊し、人間で最後に確かめる
AIに任せやすいのは、質問票の分岐を何度も通す、曖昧な表現を探す、反対意見を列挙する、インタビューの練習相手にする工程だ。ここでは正解の割合ではなく、見落としていた論点を増やすことに価値がある。
その後、少人数の人間へ質問を読み上げ、どう解釈したかを聞く。本調査では対象者の募集方法と欠測を確認する。高リスクな結論ほど、別の方法や時点でも確かめる。AIを人間の代用品ではなく、人間へ聞く前の厳しいリハーサル相手にする。
Pewの検証が示したのは、AIが何も答えられないことではない。むしろ、もっともらしく、速く、迷わず答えられるからこそ、数字の由来を分ける必要があるということだ。合成回答で仮説を増やし、人間の回答で現在を測る。速さと代表性を一つの数字に押し込まない。 これが、AI時代の調査設計の出発点になる。
資料確認日:2026年10月1日。本稿はPew Research Centerの米国調査を編集部が分析したもので、Pew Research Centerは本稿の分析・解釈に責任を負わない。図版は原文のまま掲載し、Pewの承認・推奨を示すものではない。X上の当該発表の原投稿と確認可能な反応数は確認できなかった。
Sources / 参考資料
Pew Research Center:2 Methodology: Silicon Samples
Pew Research Center:3 Synthetic surveys and timely and topical questions
Pew Research Center:4 How synthetic polling results change based on the AI model
American Association for Public Opinion Research:5 Responsible AI Integration in Survey Research / Standards and Ethics
NIRA総合研究開発機構:6 AI仮想市民の活用、民主政治における可能性とリスク
Political Analysis:7 Synthetic Replacements for Human Survey Data? The Perils of Large Language Models