FacebookやInstagramで商品や記事を紹介する。投稿には自社サイトへのリンクを置く。その日常的な発信が、リンク先サイトの内容をMetaが収集し、別の製品にも使うことへの同意になるとしたら、どこまでを「SNSを使う契約」と呼べるだろうか。
Metaは2026年10月、事業者と出版社向けの商用規約を11月20日に変更する予定だった。提案には事業者に関連するドメイン、ページ、URLをindex、cache、analyze、collect、retrieve、crawlできるという趣旨の文言が含まれていたと報じられている。出版社の反発やノルウェーでの暫定差止めを受け、Metaは変更を停止した。英国の競争・市場庁(CMA)も調査を始めたが、違反を認定したわけではない。[1][2][3][4]
今回の停止を「AI学習をめぐる対立」の一言で済ませると、実務で分けるべきものが見えなくなる。商用アカウントの契約、クローラーが技術的に読める範囲、コンテンツを使う目的と権利、拒否したときの流通への影響は、それぞれ別の判断である。本稿は英国とノルウェーで起きたことを起点に、日本のコンテンツ事業者が見直せる4つの境界を整理する。
規約変更は止まったが、争点は消えていない
CMAの発表によると、Metaの提案した条件は、FacebookやInstagramを使う事業者や出版社のウェブサイトからコンテンツを収集し、AIを含むMeta製品に使うことを認めさせる可能性があった。CMAが問題にしているのは、サイトの収集そのものだけではない。事業者に「受け入れるか、プラットフォームを離れるか」という選択を迫る条件が、公正で合理的かという競争上の問いである。[1]
出版社側のAAPは商用機能を使う条件と、出版社が管理するドメイン全体への広いアクセス許諾を結びつけることに反対した。ノルウェーでは同国の新聞発行部数の大半を代表する業界団体MBLの申し立てを受け、オスロ地裁が新条件の実施を最終判断まで禁じる暫定措置を出した。ただし、AAPとMBLの主張は当事者の評価であり、裁判所やCMAによる最終的な違法認定ではない。[3][4]
Meta側の説明も分けて読む必要がある。同社広報は、変更は第三者サイトの商品情報を広告やコンテンツ推薦へ正確に反映するためで、ニュース記事をスクレイピングする目的ではなく、既存のクローラー運用も変えないと説明した。その後、条件からは「train」という語が外された。[2] CMAの10月30日の発表では、11月20日に予定されていた変更は停止中とされている。[1]
ここで確認できるのは、目的をめぐる説明と、許諾文言の広さに開きがあったことだ。実際に何が収集され、どの製品へ使われたかという実績は、今回の資料だけでは確認できない。だから「Metaが全記事をAI学習した」とも、「商品情報だけなら問題はない」とも結論づけられない。停止は争点を消したのではなく、提案された権限と説明された目的の対応を問い直す時間をつくった。
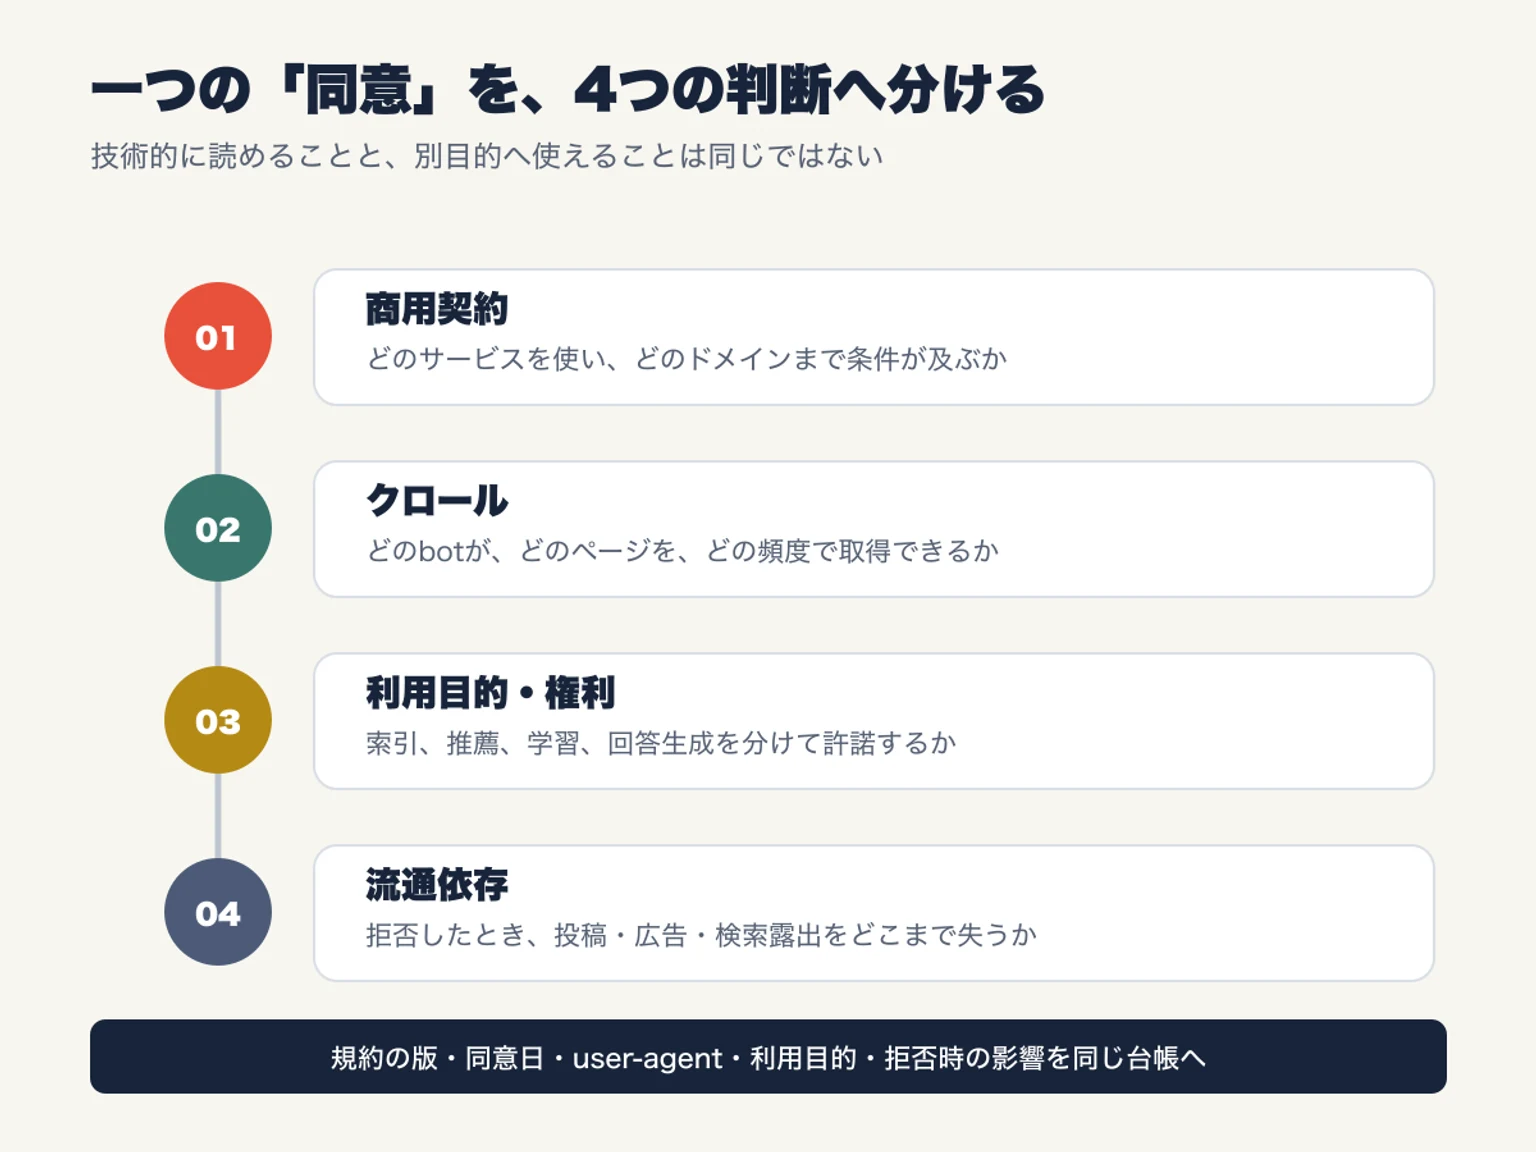
一つの「同意」に見えるものを、4つへ分ける
第1は商用契約への同意である。事業者はアカウントを開き、ページを運用し、広告や分析機能を使うための条件を受け入れる。しかし、その契約が自社サイトのどのドメイン、どのページ、どの種類のデータまで及ぶかは別に確認しなければならない。投稿への同意と、リンク先全体の利用許諾を同じ箱に入れないことが出発点になる。
第2は技術的なクロール可否である。robots.txt、WAF、アクセスログは、クローラーに読ませる範囲や実際のアクセスを管理する手段になる。一方、技術的に取得できることは、その内容をあらゆる目的に使える権利を意味しない。逆に、robots.txtで拒否したから契約や法律上の論点が自動的に解決するわけでもない。
第3は利用目的と権利処理である。検索索引、商品推薦、AIの学習、回答生成、広告最適化では、入力も出力も事業者への影響も異なる。目的を一語の「AI」で束ねると、何に同意し、何を拒否したいのかを決められない。Meta側が説明した商品情報の正確性と、出版社側が懸念したニュース利用は、同じクローリング技術を使い得ても、検討すべき目的が違う。[2][3]
第4は流通への依存である。条件を拒否できても、その結果として投稿、広告、分析、検索露出が大きく失われるなら、形式上の選択肢と実質的な選択可能性は一致しない。CMAの調査はこの力関係を見ている。[1] 以前取り上げたMeta Oneの有料化でも、複数機能の束ね方が事業者の選択を変える点が焦点になった。今回も、利用料ではなくコンテンツへの権限が束ねられることが核心である。
4つを分けると、担当者が残すべき記録も変わる。規約の版と同意日、接続したドメイン、クローラーのuser-agentとアクセス先、説明された利用目的、拒否時に失う機能や流入を一枚の管理表へまとめる。どれか一つの設定画面だけを「同意の証拠」にしないためである。
日本では、robots.txtの法的効果と透明性が残る
日本の制度を、英国やノルウェーの判断へそのまま重ねることはできない。英国では支配的プラットフォームが事業者へ提示する契約条件と競争が前面にある。一方、日本の文化庁資料はAI開発・利用と著作権法の関係を、非享受目的の権利制限などから整理している。文化庁自身も、AIと著作権をめぐる判例・裁判例の蓄積がないと説明している。[6]
日本新聞協会は10月30日の意見で、robots.txtによる拒否や、収集データを将来データベースとして提供する可能性は、著作権法30条の4の適用を考える要素になり得る一方、robots.txtの法的効果は明確でないと指摘した。さらに、クローラーの識別情報、オプトアウトの実効性、学習データや利用目的に関する情報の非対称性を問題にしている。[5]
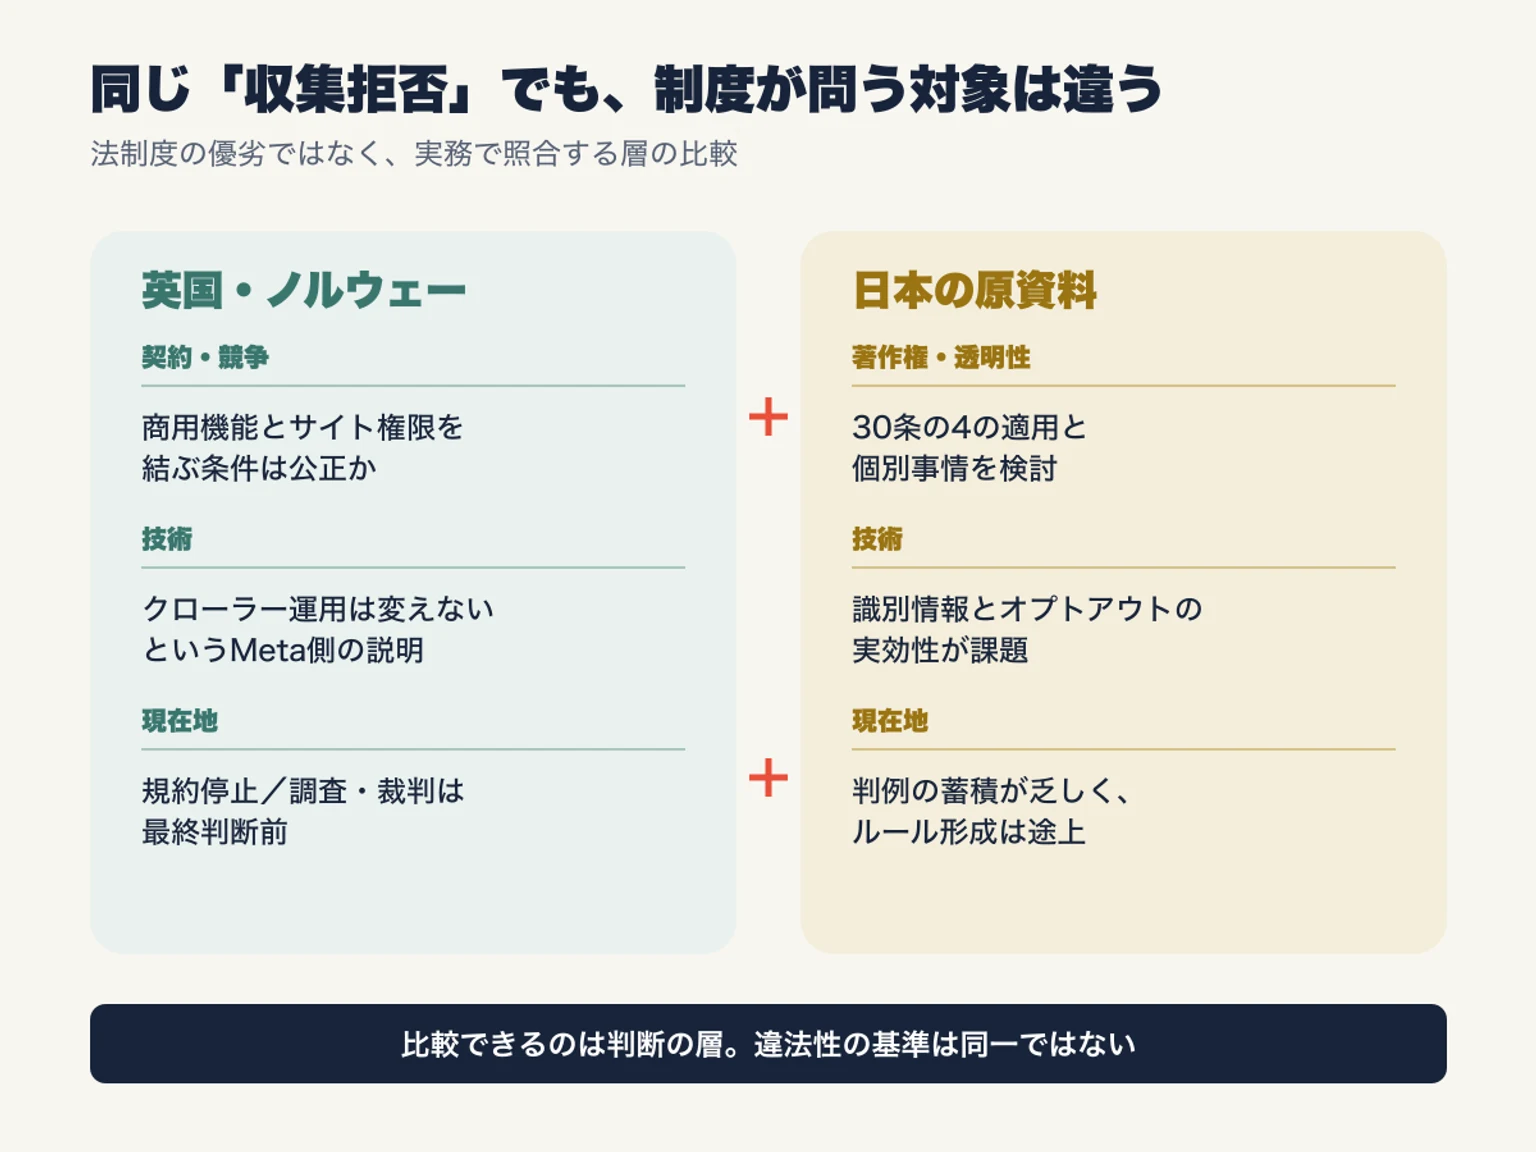
- 見る層: 契約・競争|英国・ノルウェーで確認できる論点: 商用機能の利用と関連サイトへの広い権限を結ぶ条件が公正か|日本の原資料で確認できる論点: 今回の資料だけでは同じ契約条件への判断は確認できない
- 見る層: 技術|英国・ノルウェーで確認できる論点: クローラー運用は変えないというMetaの説明|日本の原資料で確認できる論点: クローラー識別とオプトアウトの実効性が不足
- 見る層: 権利・目的|英国・ノルウェーで確認できる論点: 商品情報・推薦という説明と、出版社が懸念するニュース利用の差|日本の原資料で確認できる論点: 非享受目的の権利制限と、robots.txt等を含む個別事情の評価
- 見る層: 現在地|英国・ノルウェーで確認できる論点: 規約変更は停止、CMA調査と裁判は継続|日本の原資料で確認できる論点: ルール、透明性、契約・対価形成がなお途上
この比較から見えるのは、「robots.txtを書けばよい」でも「規約を読めばよい」でもない。検索とAI回答が同じクローラーや配信基盤に結びつけば、AIだけを拒否したい事業者が通常検索の流入まで失うことがある。Google AI検索とLLMOの記事で確認したように、機械から読める構造を整えることと、どの用途へ読ませるかを選ぶことは同じではない。技術、契約、権利、事業影響を横断して初めて、選択の実効性を評価できる。
配信経路とコンテンツの境界を守る3つの学び
1. 配信経路を借りることは、利用目的を白紙委任することではない
今回の提案では、商用機能の利用条件と関連ドメインへの権限が結びついたことが反発を招いた。これはSNSに限らず、ECモール、求人媒体、予約サイトにも移せる原則である。まず、自社が接続しているドメインとページを一覧にし、各サービスが取得すると説明する対象と目的を、規約の版・確認日とともに記録する。「アカウントを使う」を、無限定のサイト利用許諾へ読み替えない。
2. クローラー制御と権利処理を、同じ担当欄に押し込まない
robots.txtやWAFは入口を管理するが、取得後の利用目的や法的評価を一つで決めない。逆に契約文言だけでも、実際にどのbotが何を読んだかは分からない。今週の小さな行動はアクセスログから主要クローラーのuser-agent、取得先、頻度を確認し、法務・編集側の利用許諾記録と突き合わせることだ。用途を識別できないクローラーは「許可済み」と推定せず、不明として残す。
3. 拒否できるかではなく、拒否しても選べるかを測る
CMAの問いは同意ボタンの有無だけでなく、拒否した事業者がプラットフォームを離れられるかに向いている。コンテンツ事業者もSNS経由のセッション、会員登録、購買、指名検索を分けて計測し、失うものを把握しておく必要がある。RSS、メール、ブックマーク、直接流入など独立した到達経路を小さく育てれば、規約変更への回答を「全面同意か撤退か」の二択にしなくて済む。
Metaの規約変更は停止された。しかし、SNSを使うことと、自社サイトを別の目的へ使わせることの境界は、次の規約変更でも問われる。必要なのはプラットフォームを一律に拒絶することではない。契約、クロール、利用目的・権利、流通依存を分け、どの層で誰が何を決めたかを読み戻せる状態にすることだ。それが、配信の利便性を得ながら、コンテンツの条件を自分で決め続けるための最低限の設計になる。
Sources / 参考資料
2. Search Engine Journal:Meta's New Terms Expand Crawling Rights Beyond Advertisers
3. Association of American Publishers:Publishers Demand that Meta Drop Onerous New Terms of Service
4. Mediebedriftenes Landsforening:Norske mediehus har vunnet frem i retten mot Meta
5. 日本新聞協会:生成AI時代の知的財産権検討会 中間とりまとめ(案)に対する意見
6. 文化庁:AIと著作権について