AIに読ませたくないページが見つかった。担当者はrobots.txtへ二行を書き足し、これで検索からも消え、学習にも使われず、外部から開けなくなったと考える。ところが、URLは検索結果に残り、利用者が頼んだAIはページへ来る。機密ページなら、人のブラウザからも開けたままである。
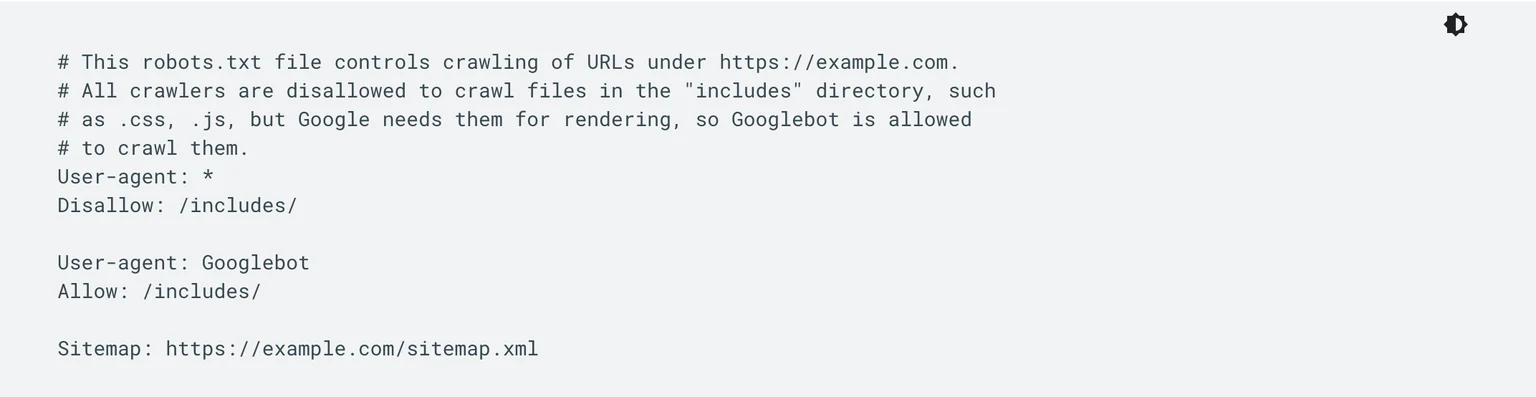
robots.txtとは、Webサイトの最上位に置く公開テキストである。自動取得するクローラーは訪問前にこのファイルを読み、自分に対応するUser-agentと、取りに行くURLパスのAllow、Disallowを照合する。サイト側が決められるのは、ルールに従う取得者が、どのパスへアクセスしてよいかである。[1]
したがって、robots.txtは準拠するAIクローラーの自動取得を止められる。しかし、アクセスを強制的に遮る鍵ではない。検索結果からURLを消す命令でも、過去に取得された内容を消す命令でもない。利用者の依頼で動く取得者には適用されない場合もある。
本稿では、AIO・GEO・LLMOで何を変えるかと、GoogleのAI検索で必要になる通常の検索要件を踏まえ、robots.txtの記述を、取得、検索掲載、学習、秘密保護へ分けて読む。
robots.txtが決めるのは、誰がどのURLを取りに行けるか
標準仕様のRFC 9309は、robots.txtを自動クライアントへアクセス規則を示す仕組みとして定める。ファイル名は小文字の「/robots.txt」で、サイトの最上位に置く。UTF-8のプレーンテキストとして配信し、ルールはそのファイルを置いたプロトコル、ホスト、ポートにだけ適用される。[1][3]
たとえば「https://example.com/robots.txt」の指定は、「https://www.example.com/」や「http://example.com/」にはそのまま及ばない。サブドメインや別ポートを使うなら、それぞれの最上位で公開する。Anthropicも、拒否したいサブドメインごとにファイルを置くよう案内している。[7]
- 対象:User-agent行で、どのクローラーの製品トークンへ規則を渡すかを決める
- 動作:Allowは取得を許可し、Disallowは取得を拒否する
- 範囲:続くURLパスで対象を絞る。Disallowの「/」はサイト全体、「/private/」はそのパスから始まる範囲を示す
ルールは上から最初に一致した行で決まるわけではない。RFCでは、該当するAllowとDisallowのうち、もっとも長く一致するパスを優先する。同じ長さならAllowを使うことが推奨されている。どの規則にも一致しなければ取得は許可される。[1] 意図した例外が実際に長いほうのパスになっているかを確かめる必要がある。
標準が定める中心はUser-agent、Allow、Disallowである。SitemapやCrawl-delayのような追加行は、取得者ごとの対応が異なる。GoogleはSitemapを読む一方、Crawl-delayをサポートしない。AnthropicはCrawl-delayへ対応すると説明する。[3][7] 同じファイルに書けても、すべての相手へ同じ意味で届くとは限らない。
取得を止めても、URLや過去の利用は消えない
robots.txtが働く位置は、クローラーがページ本体を取りに行く手前である。ここを止めても、すでに知られているURL、過去に取得された内容、別の経路で得た情報へ同じ命令がさかのぼるわけではない。取得拒否と、その後の保存、掲載、利用を一つの動作として扱わない。
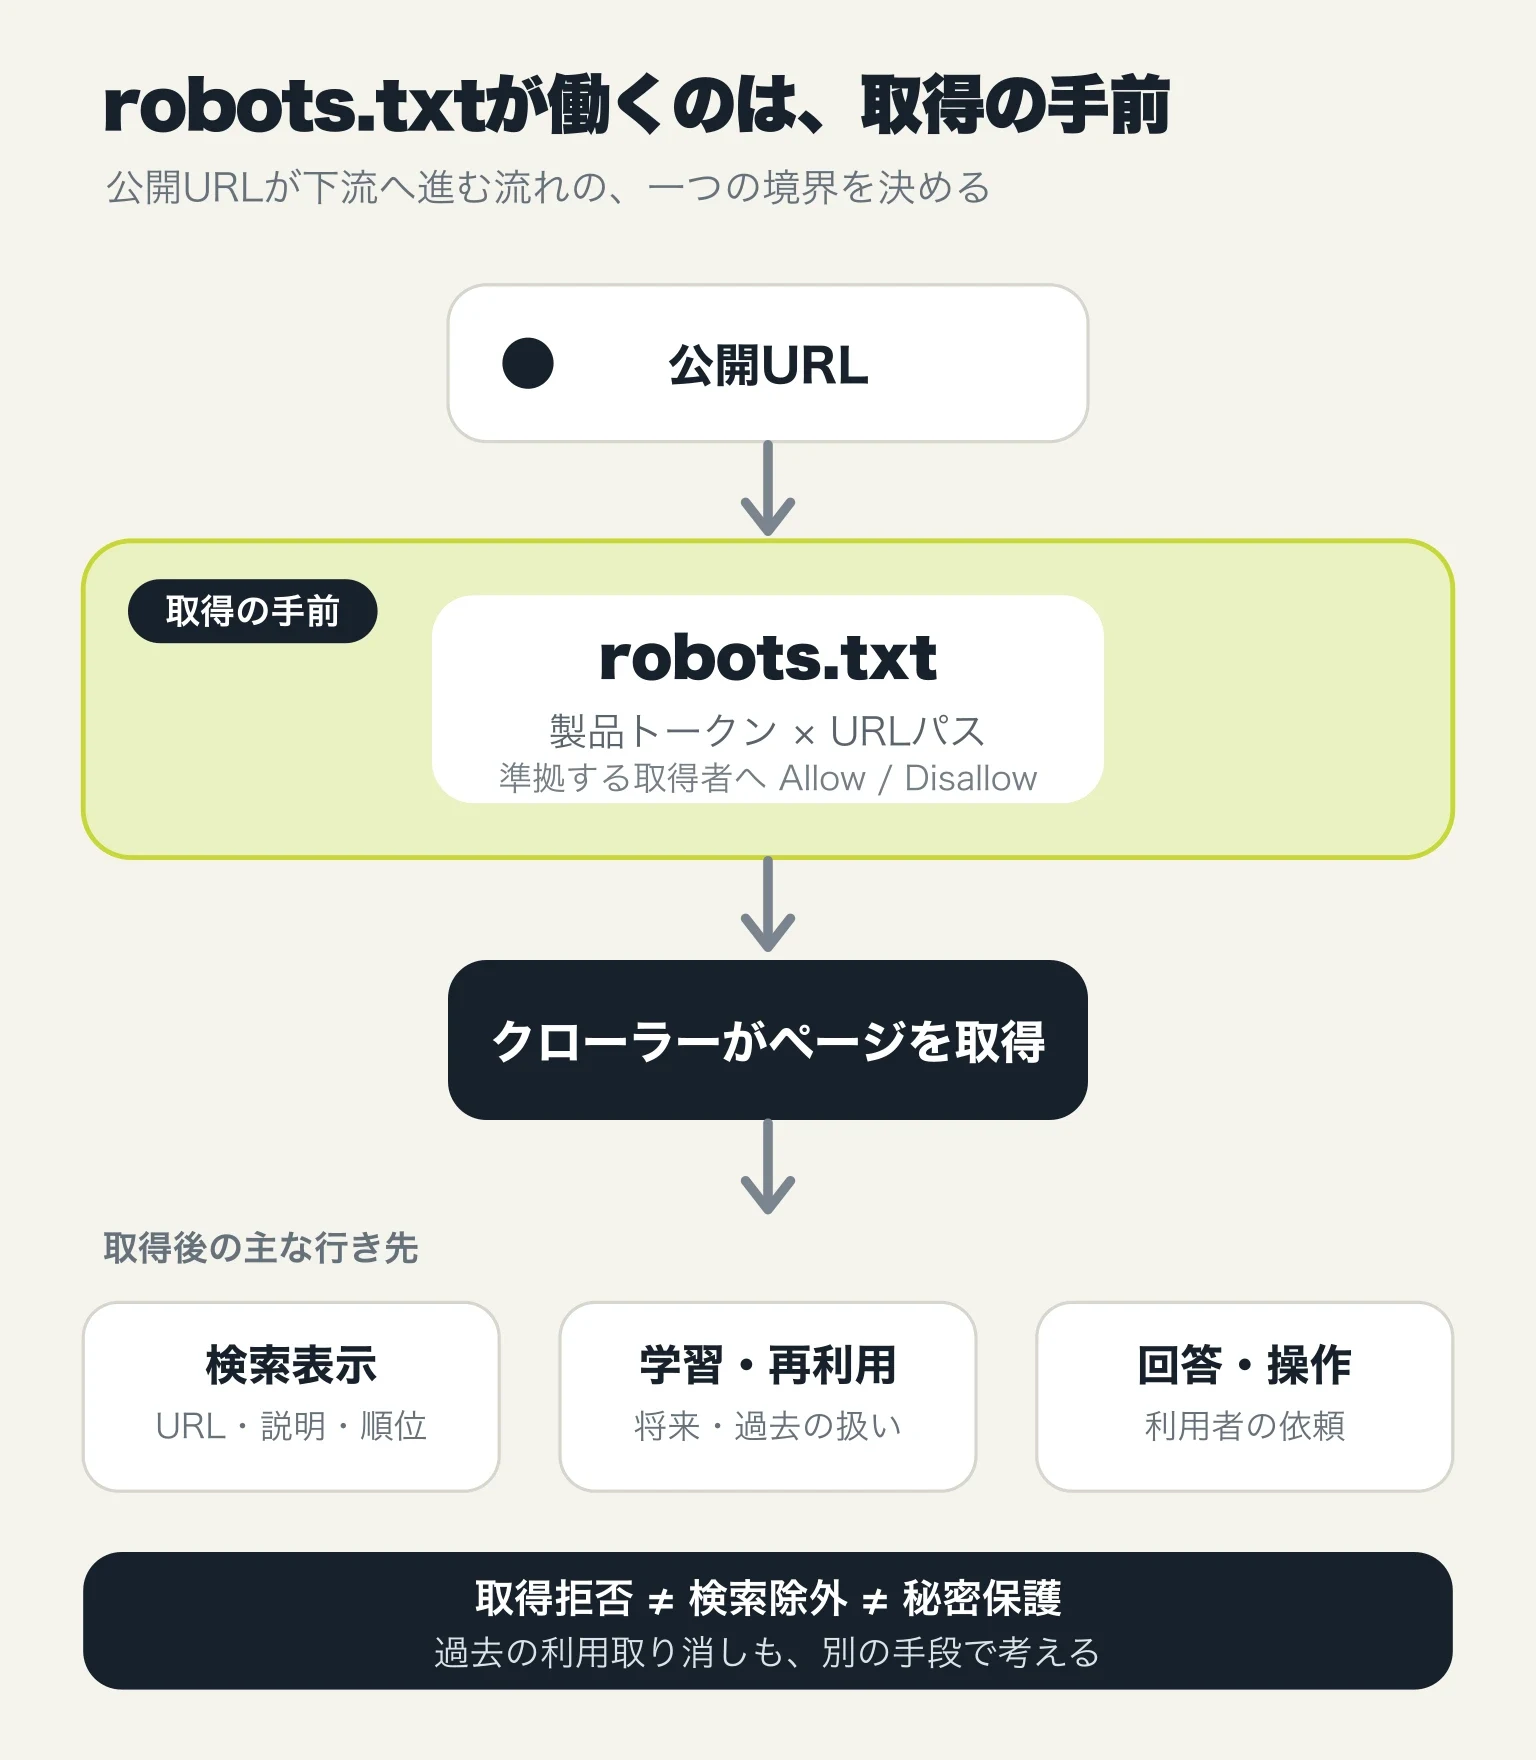
第一の限界は、秘密を守れないことだ。RFCはrobots.txtの規則をアクセス認可ではないと明記し、ファイルへ列挙したパス自体が公開されるため、適切な認証を使うよう求めている。[1] 会員限定情報、管理画面、未公開資料は、ログイン、権限確認、ネットワーク制限などでサーバー側から拒否する。
第二の限界は、Webページの検索除外と一致しないことだ。Googleは、robots.txtで本文を取得させなくても、外部リンクからURLを知り、説明文なしで検索結果へ載せる場合があると案内する。[2] 検索結果から外したいページにはnoindexを使う。ただし、Googlebotがnoindexを読むには、そのページを取得できなければならない。robots.txtで同時に遮ると、noindexが届かない。[4]

第三の限界は、変更が即時でも遡及的でもないことだ。RFCは通常、キャッシュしたrobots.txtを24時間を超えて使わないよう推奨するが、取得不能時は例外を認める。[1] OpenAIとPerplexityも反映に約24時間、または最大24時間かかる場合があると説明する。[5][8] 設定後に新しい取得が止まったことと、過去の内容が削除されたことを混同しない。
AI向けの名前は、同じ拒否でも結果が違う
AIサービスでは、一社が検索、学習、利用者代理に別々の製品トークンを用意している。robots.txtへ何を書くかは、止めたい会社名ではなく、止めたい用途から決める。次の例はサイト全体を対象にする最小形であり、既存のルールやサブドメインも合わせて確認する。
| 目的 | 対象 | 記述 |
|---|---|---|
| OpenAIの検索を許可し、学習用取得を拒否 | OAI-SearchBot / GPTBot | OAI-SearchBotはAllow: /、GPTBotはDisallow: / |
| Google検索を変えず、Gemini向け利用を拒否 | Google-Extended | Google-ExtendedにDisallow: / |
| Anthropicの将来の学習用取得を拒否 | ClaudeBot | ClaudeBotにDisallow: / |
OpenAIでは、検索表示を担うOAI-SearchBotと、学習に使う可能性がある内容を取るGPTBotを独立して指定できる。OAI-SearchBotを拒否するとChatGPTの検索回答に表示されなくなるが、ナビゲーション用リンクとして残る場合がある。GPTBotの拒否は、内容を生成AIの基盤モデル学習へ使わないよう示す。[5]
Google-Extendedはさらに特殊である。独立したHTTP User-Agentではなく、既存のGoogleクローラーが取得した内容を、将来のGeminiモデルの学習や回答の根拠へ使えるかを指定する製品トークンだ。拒否してもGoogle検索への掲載や順位には影響しない。[6] robots.txt内にありながら、通常の取得可否ではなく利用先を制御する事業者固有の仕組みである。
利用者の依頼で動く取得者も同じではない。OpenAIはChatGPT-Userについて、利用者起点のためrobots.txtが適用されない場合があるとする。[5] Perplexity-Userは一般にrobots.txtを無視すると説明されている。[8] 一方、AnthropicはClaude-Userを含む公開済みbotがrobots.txtに従うとしている。[7] ユーザー代理を一括で許可、拒否できる共通行はない。
この差は、robots.txtが万能なAI利用規約ではないことを示す。標準で決まる部分、各社が独自に約束する部分、そもそも適用外とする取得を分ける。公式ページの更新日と製品トークンを記録し、古いbot一覧をコピーし続けない。
公開前に、目的・対象・確認方法を一枚にする
最初に「AIを止める」を、達成したい結果へ言い換える。サーバー負荷を下げたいのか、検索結果から外したいのか、学習利用を拒否したいのか、秘密を守りたいのかで、使う手段が変わる。目的が二つなら、一つのDisallowへ押し込まず、二つの対策に分ける。
| 目的 | 主な手段 | 確認 |
|---|---|---|
| 準拠クローラーの取得を止める | robots.txt | 対象User-agent、URLパス、取得ログ |
| 検索結果からページを外す | noindex、認証、削除 | クローラーがnoindexを読める状態か、検索サービスの検査結果 |
| 非公開情報を守る | 認証と権限確認 | 未認証の人と自動取得者へサーバーが拒否を返すか |
| なりすましや過剰取得を止める | WAF、送信元確認、rate limit | User-AgentだけでなくIP、頻度、対象パス、応答を記録したか |
| 将来のAI学習や回答利用を拒否する | 各社の製品トークン、専用設定、契約 | 対象用途、適用時点、検索への影響を公式資料で分けたか |
| 過去に取得された内容の扱いを変える | 各社の申請窓口、契約・法務確認 | robots.txt更新だけで完了と扱っていないか |
次に、URLを公開記事、画像、検索結果ページ、会員限定、管理画面、無限に増えるパラメーター付きURLへ分ける。ホストとプロトコルも書く。そのうえで、対象bot、AllowまたはDisallow、併用する認証やnoindex、決定者、見直し日を一行ずつ記録する。
配信状態の確認も欠かせない。Googleはrobots.txtが404や403を返すと、429を除いて制限なしとして扱う。5xxでは最初の12時間クロールを止め、その後は直前の正常な内容を使う場合がある。[3] ファイルが存在するだけでなく、正しいホストでHTTP 200、text/plain、意図した本文を返すかを外部から確かめる。
最後に変更時刻を残し、24時間程度を一つの観察窓として、対象botの送信元を公式情報で照合する。設定前後のリクエスト数、対象パス、応答コード、転送量を見る。ログが減っても過去利用の削除までは証明せず、ログが残っても利用者代理やなりすましを自動巡回と決めつけない。
robots.txtでAIクローラーを制御する要点は、止めたい結果を先に決めることである。準拠する自動取得者とURLパスなら、公開したルールで許可と拒否を分けられる。検索除外にはnoindex、秘密には認証、不明な取得者にはWAF、過去や将来の利用には各社の説明と契約を使う。一行を万能な壁にせず、働く場所が違う手段を重ねれば、発見性を残しながら守る範囲を選べる。
Sources / 参考資料
Google Search Central:Introduction to robots.txt
Google Crawling Infrastructure:How Google interprets the robots.txt specification
Google Search Central:Block Search indexing with noindex
OpenAI Developers:Overview of OpenAI Crawlers
Google Crawling Infrastructure:List of Google's common crawlers
Claude Help Center:Does Anthropic crawl data from the web, and how can site owners block the crawler?
Perplexity Docs:Perplexity Crawlers