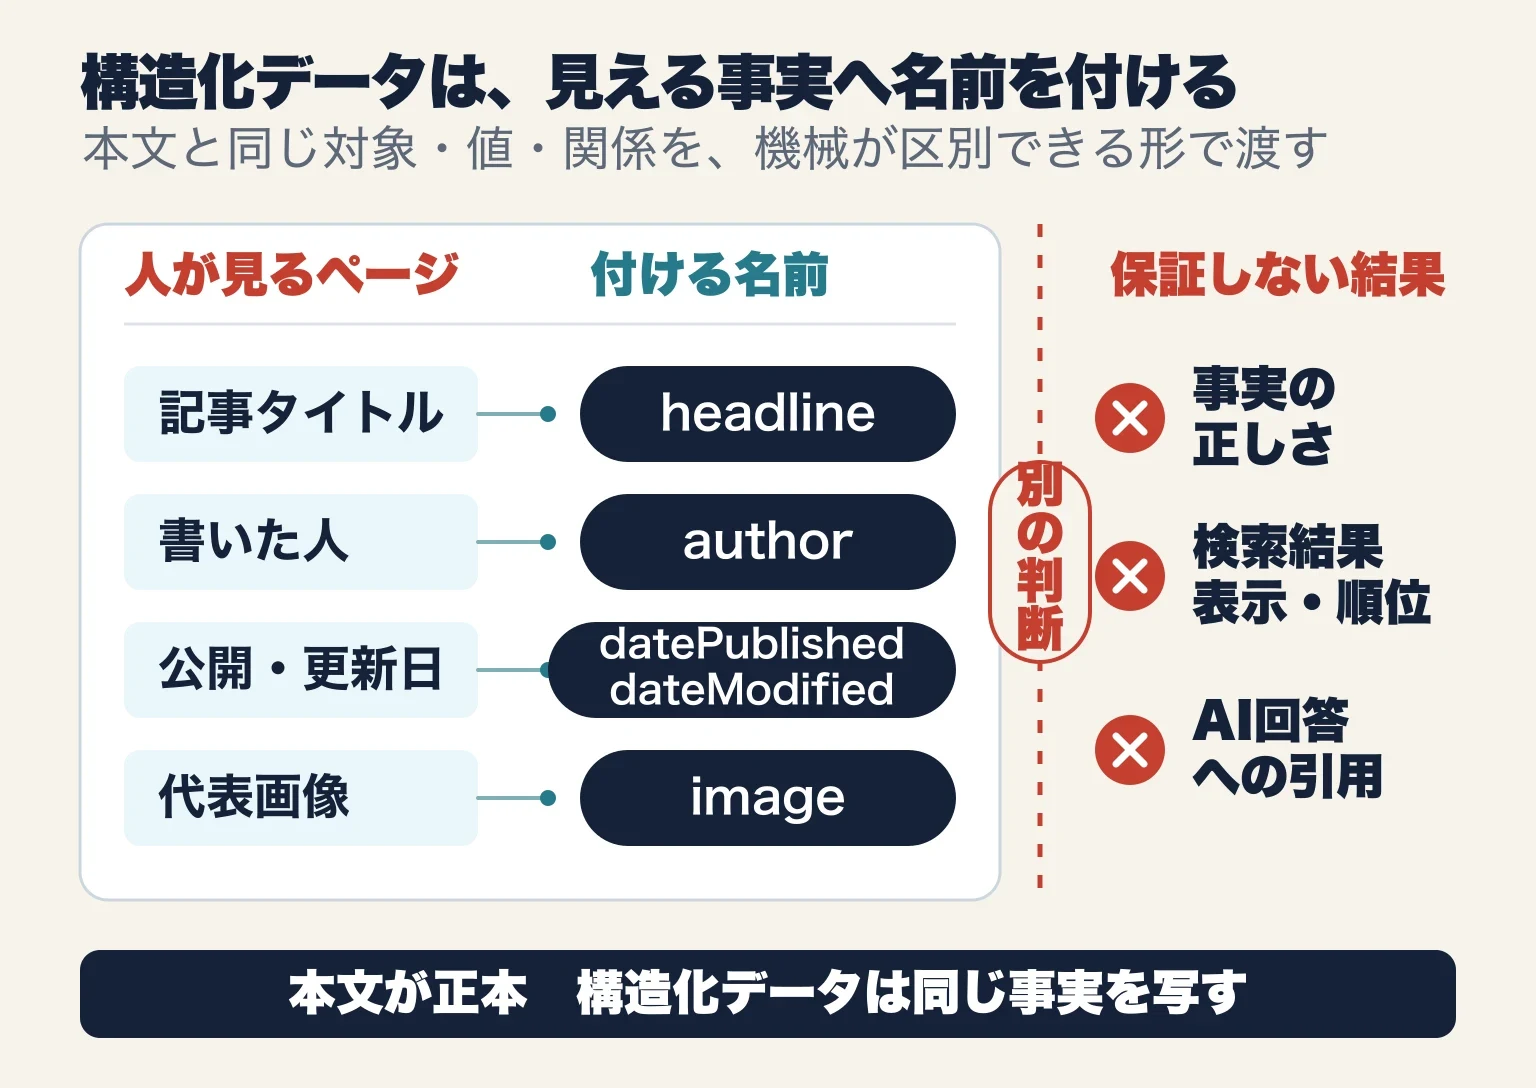
構造化データとは、ページに見えるタイトル、書いた人、公開日、画像へ、機械が区別できる共通の名前を付ける記述である。CONTEXTの記事をブラウザで開くと、ページのHTMLには同じ情報を「Article」「headline」「author」「datePublished」などで並べたJSON-LDも入っている。[S12]
たとえば「2026年9月8日」という文字列だけでなく、それが記事の公開日だと示す。人が読む本文を置き換えるのではない。すでにある対象と関係を、機械向けに明示する。[S1][S2]
AI検索に伝えられるのは、ページの種類、人物や組織、日付、画像、それらの関係である。伝えられないのは、内容が真実か、検索結果へ出るか、順位が上がるか、AI回答に引用されるかという結果だ。GoogleはAI OverviewsやAI Modeに専用のschema.orgマークアップは不要だと明記している。[S6][S7]
本稿では、GoogleのAI検索に必要な公式条件と、企業サイトで一次情報を保つ考え方を踏まえる。構造化データを増やす前に、何を正本にし、何をマークし、公開後にどこを確かめるかを順に整理する。
構造化データは、見える事実に機械向けの名前を付ける
人は記事を見れば、いちばん大きな文字がタイトルで、その下の名前が著者だと文脈から推測できる。機械には、同じ文字列が会社名、商品名、地名、書いた人のどれなのか曖昧な場合がある。Schema.orgは、その違いを表す型と項目名を、Google、Microsoft、Yahoo、Yandexなどが理解できる共通語彙として公開している。[S1]
語彙と書き方は別である。Schema.orgが「Article」「Person」「Organization」や「author」「image」といった名前を決め、JSON-LD、Microdata、RDFaが、その名前をHTMLへ記す形式になる。Google Searchは三形式を扱い、保守しやすい方法としてJSON-LDを推奨する。[S2][S3]
| 画面に見える事実 | Schema.orgの型・項目 | 機械へ伝える意味 |
|---|---|---|
| これは一本の記事である | Article | ページの主な対象は記事 |
| 記事タイトル | headline | 記事の見出しとして扱う文字列 |
| 書いた人とプロフィール | author / Person | 記事と著者を結ぶ |
| 公開日と更新日 | datePublished / dateModified | 二つの日付の役割を分ける |
| 記事を表す画像 | image | 記事と代表画像を結ぶ |
JSON-LDは、JSONでLinked Dataを表すためのW3C勧告である。対象をノード、関係を線として記述できるため、記事と著者、著者とプロフィール、記事と発行者を別々の文字列ではなく、関係のある対象として渡せる。[S2]
ただし、項目を増やせば理解が比例して深まるわけではない。Googleは、適用できる推奨項目をできるだけ含めつつ、不完全または不正確な項目を網羅するより、少数でも完全で正確な情報を優先するよう案内する。[S3]
2026年9月10日にCONTEXTの公開記事を確認すると、Articleの型に、タイトル、説明、画像、公開日、更新日、言語、著者、発行者、記事URLが入っていた。[S12] これらは画面の表示やURLと対応する。構造化データが新しい事実を生んだのではなく、すでに公開した事実の役割を言い直している。
AI検索専用schemaはなく、通常検索との接続を助ける
GoogleのAI OverviewsやAI Modeで、構造化データだけの特別な入口は用意されていない。Googleは、ページが通常検索に登録され、検索結果に説明文を出せることを技術上の条件とし、AI機能だけの追加要件はないと説明する。[S6]
それでも構造化データを使う意味はある。Googleは、ページの内容を理解し、対応する検索機能の候補にする手がかりとして構造化データを使う。記事、パンくず、商品、イベント、組織など、対応する型ごとに検索結果の見せ方が定義されている。[S3]
ここで「リッチリザルトの候補」と「AI回答への引用」を分けたい。前者は、画像、価格、日付などを通常の検索結果へ豊かに表示する機能である。後者は、検索システムが質問ごとにページを探し、回答の根拠として選ぶ過程を含む。構造化データが前者の候補になることは、後者への採用を約束しない。
2026年7月10日更新のGoogle公式ガイドも、生成AI検索のために構造化データへ集中しすぎないよう注意する。専用schemaはなく、生成AI検索への表示に必須でもない。一方、通常検索のリッチリザルト候補を助けるため、SEO全体の一部として続ける価値はあるとする。[S7]
- ページは記事、商品、イベント、組織などのどの型か
- タイトル、著者、発行者、画像、日付などがどの役割を持つか
- 記事と著者、商品と提供条件など、ページ内の対象がどう結び付くか
- 価格、在庫、開催日など、対応する型で定義された値は何か
Schema.orgは複数の検索エンジンが理解できる共通語彙だが、すべてのAI検索サービスが同じ項目を同じ目的で使うとは限らない。[S1] 実際の採用方法は製品ごとの公式文書で確かめる必要がある。公開説明がない用途について、共通語彙であることだけを根拠に引用効果まで広げない。
正しく書いても、表示・順位・引用は約束されない
構文が正しいことと、検索結果へ採用されることも別である。Googleは、Rich Results Testに合格した構造化データでも、リッチリザルト表示を保証しない。検索語、場所、端末、ページ品質などを踏まえ、通常のテキスト結果が選ばれる場合もある。[S4]
検査ツールが主に見つけるのは、JSONの壊れ、必須項目の不足、値の形式などである。書かれた評価が本物か、画面にないレビューを捏造していないか、主題と関係があるかまでは、構文だけで保証できない。Googleは、読者に見えない内容や誤解を招く内容をマークしないよう求める。[S4][S9]
記事向けの公式文書は2026年9月8日に更新され、Article、NewsArticle、BlogPostingを対象に、author、datePublished、dateModified、headline、imageなどを推奨している。必須項目はないが、実際の記事に当てはまる推奨項目を入れる考え方である。[S5]
組織の型は別の目的を持つ。Googleは、トップページへOrganizationを置くと、組織の管理情報や同名組織との区別を理解する助けになると説明する。名称、URL、ロゴ、住所など、利用者にも役立つ実在情報が中心である。[S8] 一つの型を全ページへ足すのではなく、ページの主題と目的に合わせる。
| 目的 | 構造化データで行うこと | 確かめる証拠 |
|---|---|---|
| 記事と著者・日付を明示する | Articleへ画面と同じ値を出す | HTML、Schema Markup Validator、Rich Results Test |
| リッチリザルトの候補にする | Googleが対応する型と項目を満たす | URL検査、Search Consoleの対象レポート、実際の検索表示 |
| 組織名やロゴの候補を伝える | トップページのOrganizationを可視情報と一致させる | URL検査、検索結果やナレッジパネルの観察 |
| AI回答で引用される | 専用schemaを探さず、本文と既存マークアップを一致させる | 対象製品の公式仕様、Search Console、同じ質問による継続観察 |
CONTEXTでは、公開記事へArticleとBreadcrumbListを出し、サイト全体へOrganizationとWebSiteを出している。[S12] すでに基本の型があるため、AI検索を理由に項目を増やすことより、CMSでタイトルや著者、日付を直したとき、画面とJSON-LDが同時に変わる状態を保つほうが優先度は高い。
追加するときは「書ける項目」ではなく「読者にも見せられ、更新責任を持てる項目」から選ぶ。古い価格、終了した在庫、実在しない評価、更新していないdateModifiedを機械だけへ渡せば、意味の明示ではなく矛盾を増やす。
正本を一つにし、同じ値を出し、公開後に確かめる
実務で最初に決めるのはJSON-LDの書き方ではない。タイトル、著者、公開日、価格、在庫など、各事実の正本がどこにあるかである。CMSの同じ項目から、画面の本文、メタデータ、構造化データを生成すれば、三つの更新漏れを減らせる。
- 目的を一つ決める。記事、商品、組織など、ページの主題に合う型をGoogleの対応一覧から選ぶ
- 画面に見える正本を決める。タイトル、著者、日付、画像などを誰が更新するか割り当てる
- 実際に当てはまる項目だけを選ぶ。値がない欄を推測で埋めない
- CMSの同じ値からJSON-LDを出す。記事ごとの手作業コピーを避ける
- Schema Markup Validatorで語彙と構文を、Rich Results TestでGoogle対応機能を検査する
- 少数のURLへ出し、URL検査でGoogleが受け取ったHTMLと検出項目を確認する
- 公開後はSearch Consoleのエラー、警告、対象URL、検索表示を追い、本文変更と同時に直す
Rich Results Testは、検出した型、エラー、警告を表示する。[S9] URL検査は、登録状態に加え、Googleが検出したリッチリザルト項目をURL単位で確認できる。[S10] テンプレートの不具合は多数のページへ広がるため、Search Consoleで同じ問題のURLをまとめて直し、修正検証の経過を追う。[S11]
効果を測るなら、構造化データを入れていない安定したページを選び、少数へ追加し、Googleが検出したことを確かめる。その後、URL別の検索表示やクリックを数カ月比べる方法をGoogle自身が案内している。[S3] 季節、順位、本文更新なども動くため、前後差だけを構造化データの因果と断定しない。
構造化データは、機械へ事実の種類と関係を渡すための配線である。配線が正しければ、検索側はページを解釈しやすくなり、対応する表示の候補にもなれる。しかし、配線は中身の正しさも、AI回答への採用も決めない。可視本文を正本にし、同じ値をテンプレートから出し、検出と表示を別々に確かめる。AI検索が広がっても、この順序は変わらない。
Sources / 参考資料
W3C:JSON-LD 1.1
Google Search Central:Introduction to structured data markup in Google Search
Google Search Central:General structured data guidelines
Google Search Central:Article structured data
Google Search Central:AI features and your website
Google Search Central:Optimizing your website for generative AI features on Google Search
Google Search Central:Organization structured data
Google Search Console Help:Rich Results Test
Google Search Console Help:URL Inspection tool
Google Search Console Help:Fix structured data issues in Search Console
CONTEXT:Google AI Modeとは——従来検索と変わる探索の流れ