OpenAIの開発者サイトでURLの末尾に「/llms.txt」を加えると、サイトの概要と文書へのリンクを並べたテキストが開く。llms.txtとは、サイト運営者がAIエージェントへ概要と先に読むページをMarkdownで渡す公開提案である。[S1][S5]
Anthropic、Perplexity、Gemini APIの文書サイトにも、同じ名前のファイルがある。[S6][S7][S8] AIを提供する会社が自ら置いているなら、自社サイトにも追加すればAI検索で評価される。そう考えたくなる。しかし、案内を公開した事実と、その会社の検索製品が外部サイトの同名ファイルを読み、順位や引用へ反映する事実は別である。
対応する利用者には、llms.txtが案内板として役立つ。一方、設置だけでAI検索の評価が上がるとは確認できない。Google Searchは、llms.txtを検索には使わず、表示や順位を上げも下げもしないと明記している。[S3]
本稿では、AIO・GEO・LLMOの違いで触れたllms.txtを、2026年8月のv2に合わせて検証する。GoogleのAI検索に必要な通常の検索要件と照らし、何が確認できれば導入する意味があるのかを分ける。
llms.txtは、AIへ「まず読むページ」を渡す案内板である
llms.txtは、Jeremy Howardが2024年9月3日に公開した提案から始まった。2026年8月10日に更新されたv2は、サイトの最上位だけでなく「/docs/llms.txt」のような下位の場所にも置けるとする。その場所より下にあるページの案内を担当し、複数あるときは、より近い場所のファイルを使う考え方だ。[S1][S2]
読む側は、まず小さなllms.txtを取得する。そこに並ぶ短い説明から必要なページを選び、そのリンク先を読む。全ページの本文を一つのファイルへ複製するのではない。詳しい情報は元ページに残し、llms.txtは入口を絞る。[S1]
- 必須:最初のH1へサイトまたはプロジェクトの名前を書く
- 任意:引用形式の短い概要と、残りを読むための補足を書く
- 任意:H2ごとに、ページ名、URL、短い説明を並べる
- 補助:個別ページのMarkdown版と、HTMLやHTTPヘッダーから案内先を示すlink relationを用意する
H1だけが必須で、残りは任意である。v2は、HTMLページと同じ内容のMarkdown版を「.md」を付けたURLで提供する方法も認めた。通常のページから両方へたどれるよう、「alternate」と「describedby」のlink relationも提案する。[S1][S2]
| ファイル | 主な相手 | 渡すもの | 証明しないこと |
|---|---|---|---|
| robots.txt | 準拠する自動取得者 | どのURLパスを取得してよいかという規則 | 秘密保護や検索順位 |
| sitemap.xml | 検索エンジン | 重要だと考えるページや画像などのURL一覧 | クロールや登録の保証 |
| llms.txt | 対応するAIエージェント | 概要と、先に読むページへの案内 | すべてのAIによる利用や検索評価 |
robots.txtは取得の許可を求める標準であり、sitemap.xmlは検索エンジンがURLを見つけるのを助ける。llms.txtは、許可でも全件一覧でもなく、運営者が選んだ入口である。[S11][S12] 選ぶ価値はあるが、選んだ内容が正しいか、新しいかという責任も運営者へ戻る。
公開例が増えても、外部サイトでの利用までは証明しない
2026年9月10日時点で、OpenAI、Anthropic、Perplexity、Gemini APIの開発者向けサイトはllms.txtを公開している。OpenAIは複数の文書群、Anthropicは言語別の文書を案内する。PerplexityはAPI文書、GeminiはGemini APIのページを並べる。[S5][S6][S7][S8]
この事実が示すのは、各社が自社の開発者向け文書をエージェントへ渡しやすくしている点だ。ファイルがHTTP 200で開き、リンク先へ移動できる状態も確認できる。これは「公開された」という第一段の証拠になる。
しかし、その会社の検索botや回答サービスが、第三者サイトのllms.txtを決まった方法で探すとは限らない。公開ファイルは提供側の選択であり、利用側の仕様書ではない。外部サイトでの取得、回答への参照、検索順位への利用は、それぞれ別の公式説明や観測が必要になる。
提案元のv2は、数千のサイトがファイルを公開し、coding agentで使われていると説明する。[S1][S2] これは普及を知る材料だが、AI検索の掲載や順位が上がったサイトと、上がらなかったサイトを比べた検証ではない。採用数と効果を同じ数字にしない。
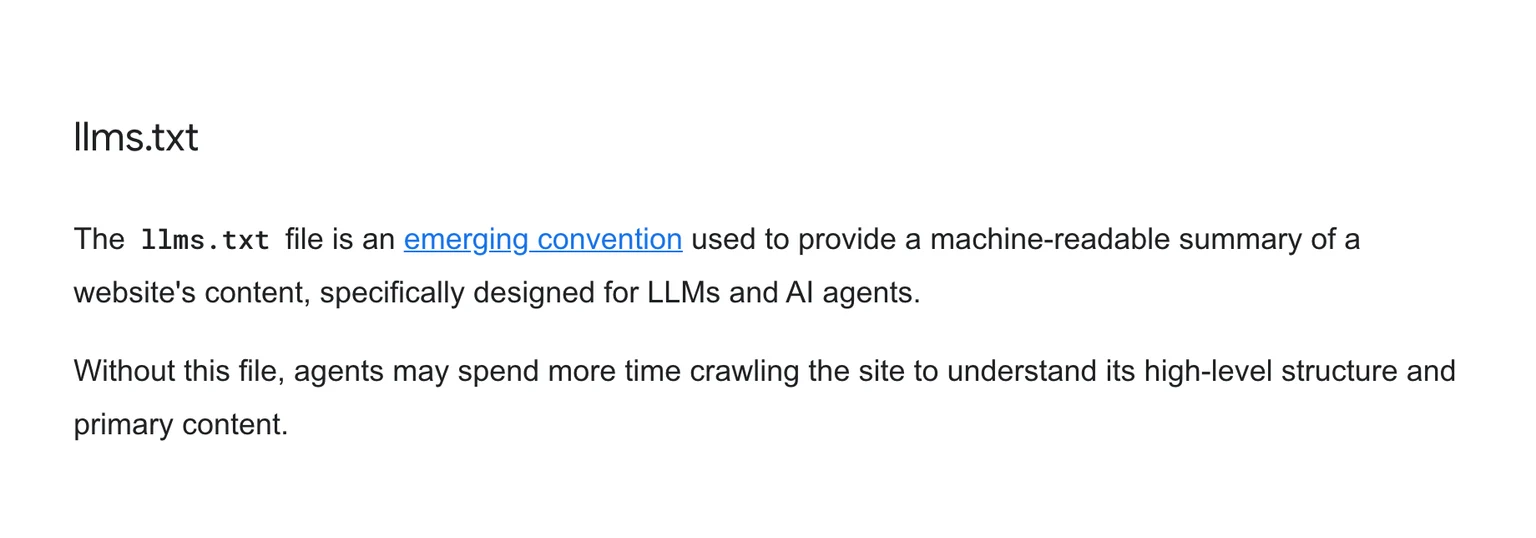
ChromeのLighthouseにもllms.txtの検査がある。ただし文書は、このファイルを「新しい慣行」と呼び、404なら検査結果をN/A、つまり対象外にする。サーバーエラーは問題として示すが、ファイルがないこと自体は失敗にしない。[S4] ここでも確認できるのは、任意の案内を正しく配信できるかまでである。
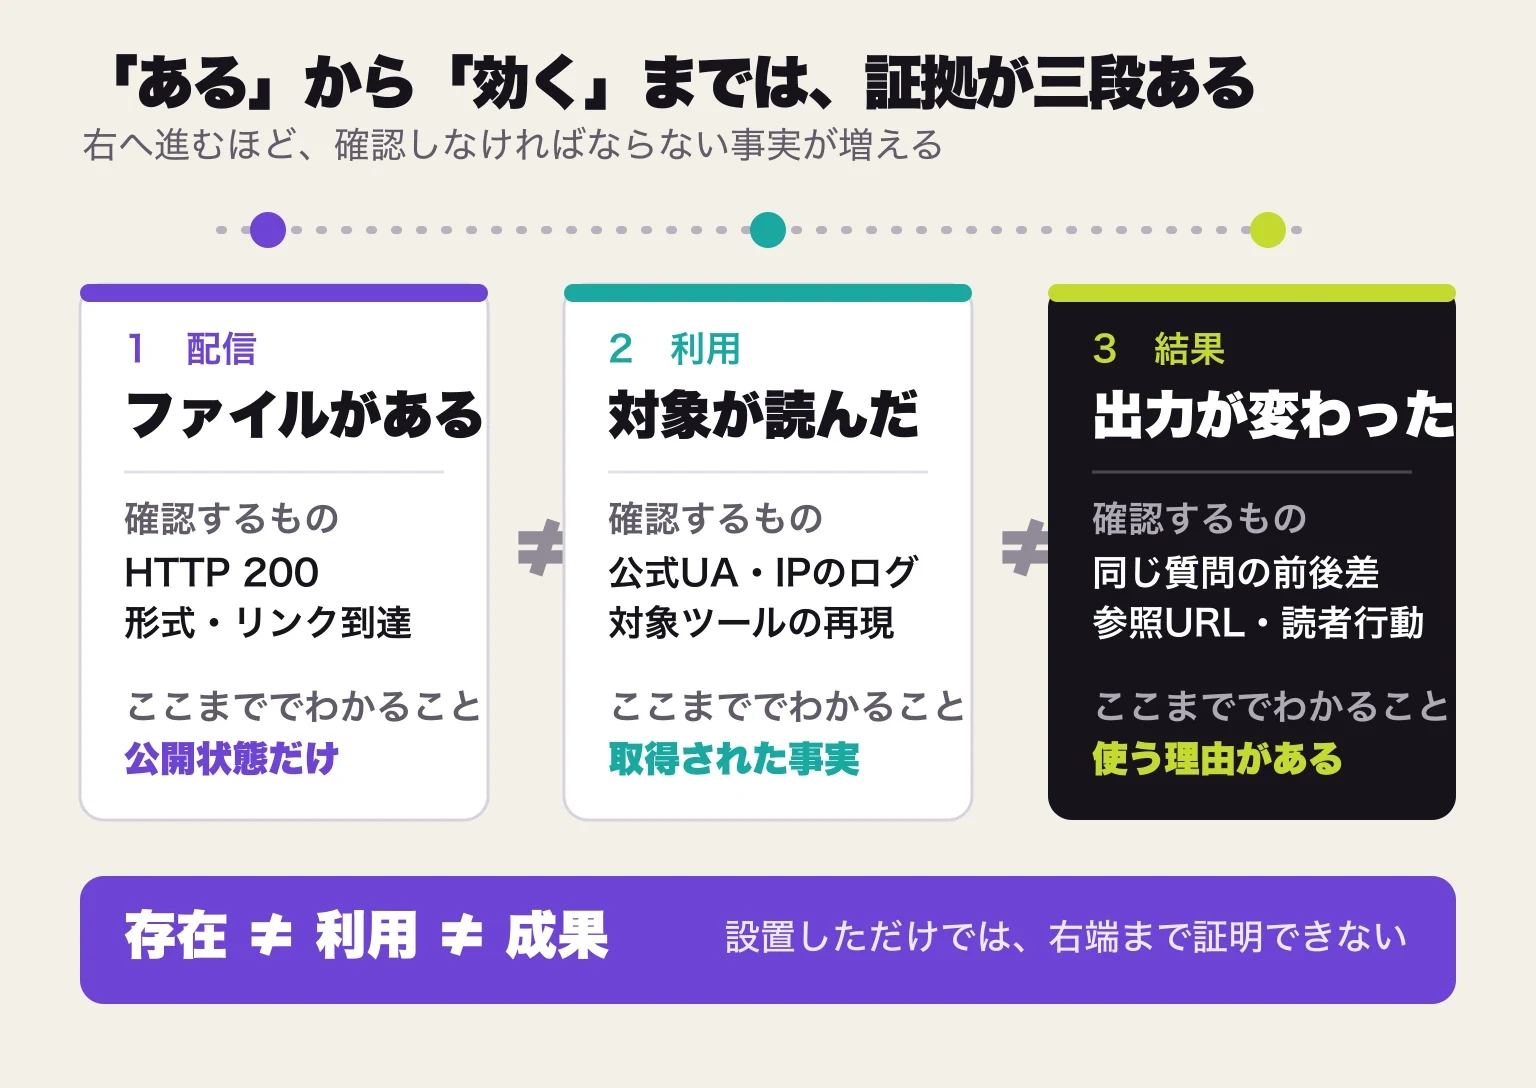
「ある」から「効いた」へ進むには、二つの空白を埋める。対象のエージェントが取得したことをログや再現テストで確かめ、そのうえで、同じ質問への回答、参照URL、問い合わせなどが変わったかを見る。第一段だけを見て第三段を断定すると、効果のない保守作業を増やす。
Google検索では、置いても順位を上げも下げもしない
Google Searchは2026年7月10日更新の公式ガイドで、llms.txtを検索では使わないと明記した。設置しても、Google検索の表示や順位を上げも下げもしない。GoogleのAI OverviewsやAI Modeに出るための特別なファイルも不要である。[S3]

必要なのは、通常の検索でページが登録され、検索結果に説明文を出せる状態である。Googleは、クロールを許可し、内部リンクで見つけやすくし、重要な内容を可視テキストへ置き、構造化データを本文と一致させるよう案内する。[S10] llms.txtを足しても、この土台の代わりにはならない。
では、Googleが提供するLighthouseの検査と矛盾するのか。矛盾しない。Lighthouseの該当検査は、ブラウザを使うAIエージェント向けの任意項目である。[S4] Google Searchの文書は検索表示と順位を説明する。[S3] 同じ会社の製品でも、読む目的と成功条件が違う。
OpenAIも製品別に見る必要がある。開発者向け文書ではllms.txtを案内に使う。一方、ChatGPT検索への表示を管理する公式ページは、OAI-SearchBotとrobots.txtを説明する。[S5][S9] 自社文書での採用を、外部サイトの検索掲載条件へ広げてはいけない。
したがって「AI検索に効くか」という一問へ、全サービス共通の答えは出せない。Google検索には効かない。明示的に読むエージェントには案内として使える。対応を公表していないサービスは未確認である。会社名ではなく、対象製品、取得方法、期待する結果を一つずつ確認する。
導入は、誰が読むかと更新方法を先に決める
llms.txtを作る価値が出やすいのは、読む相手がわかっている場合だ。自社の開発者文書を特定のcoding agentへ渡す、問い合わせ用エージェントへ公式ページだけを読ませる、社内ツールが決まったURLから案内を取得する。こうした用途なら、導入前後を同じ条件で比べられる。
| 目的 | 判断 | 先に行うこと | 証拠 |
|---|---|---|---|
| Google検索やAI Modeの順位を上げたい | llms.txtは使わない | 公開ページ、内部リンク、クロール、登録、可視本文を直す | Search Consoleと公式検索要件 |
| 対応するcoding agentへ大きな文書群を案内したい | 小さく試す | 対象ツールがllms.txtまたは指定URLを読むか確認する | 取得ログと同じ質問による再現テスト |
| AI検索への掲載を許可または拒否したい | 対象事業者の公式設定を使う | robots.txtの製品トークンや検索設定を確認する | 公式文書、配信内容、botログ |
| 社内AIへ正しい参照先を固定したい | 利用する仕組みが対応するなら使う | 取得先と引用方法をアプリ側で指定する | テスト結果、参照URL、回答の差 |
| 担当者が手作業で人気ページを並べたい | 更新元が一つになるまで待つ | CMSや文書一覧から自動生成できる状態を作る | リンク切れ検査と更新履歴 |
試すなら、最初は短くする。H1の名前、誰の何を助けるサイトかを示す概要、重要な公開ページへのリンクと一行説明だけでよい。ページ数の多さを競わず、対象のエージェントが迷う分岐だけを減らす。リンク先は、人にも読める最新の一次情報にする。
更新は本文と同じ元データから行う。手作業で複製すると、終了した機能、古い価格、移動したURLが案内に残る。公開前にHTTP状態、リンク切れ、重複、最終更新を検査し、ファイルを消しても元ページの品質が下がらない関係を保つ。
公開ファイルへ、会員限定ページや管理画面の場所を新しく書かない。利用条件や学習拒否を書き足しても、それだけで相手へ強制できるとは限らない。秘密は認証、取得の希望はrobots.txt、契約上の扱いは利用規約や個別契約で決める。llms.txtへ別の役割を背負わせない。
llms.txtは、対応するエージェントへ読む道筋を渡すには合理的である。だが、AI検索で評価されるための入場券ではない。誰が読むかを特定でき、同じ元データから更新でき、取得と結果を測れるなら試す。そこまで決まっていないなら、まず公開ページの一次情報、内部リンク、検索登録を保つほうが、読者にも検索にも残る仕事になる。
Sources / 参考資料
llms-txt / Jeremy Howard:Changes: v2 (August 2026)
Google Search Central:Optimizing your website for generative AI features on Google Search
Chrome for Developers / Lighthouse:llms.txt
OpenAI Developers:OpenAI Developers llms.txt
Anthropic:Anthropic Developer Documentation llms.txt
Perplexity Docs:Perplexity llms.txt
Google AI for Developers:Gemini API llms.txt
OpenAI Developers:Overview of OpenAI Crawlers
Google Search Central:AI features and your website
Google Search Central:Learn about sitemaps
RFC Editor / IETF:RFC 9309: Robots Exclusion Protocol