顧客がSaaS企業へ尋ねた。`入力した相談内容も、生成AIの学習に使われますか`。営業は使わないと答え、開発は社内文書をRAGで参照すると言う。法務は外部AIの規約に改善利用の記載を見つけた。
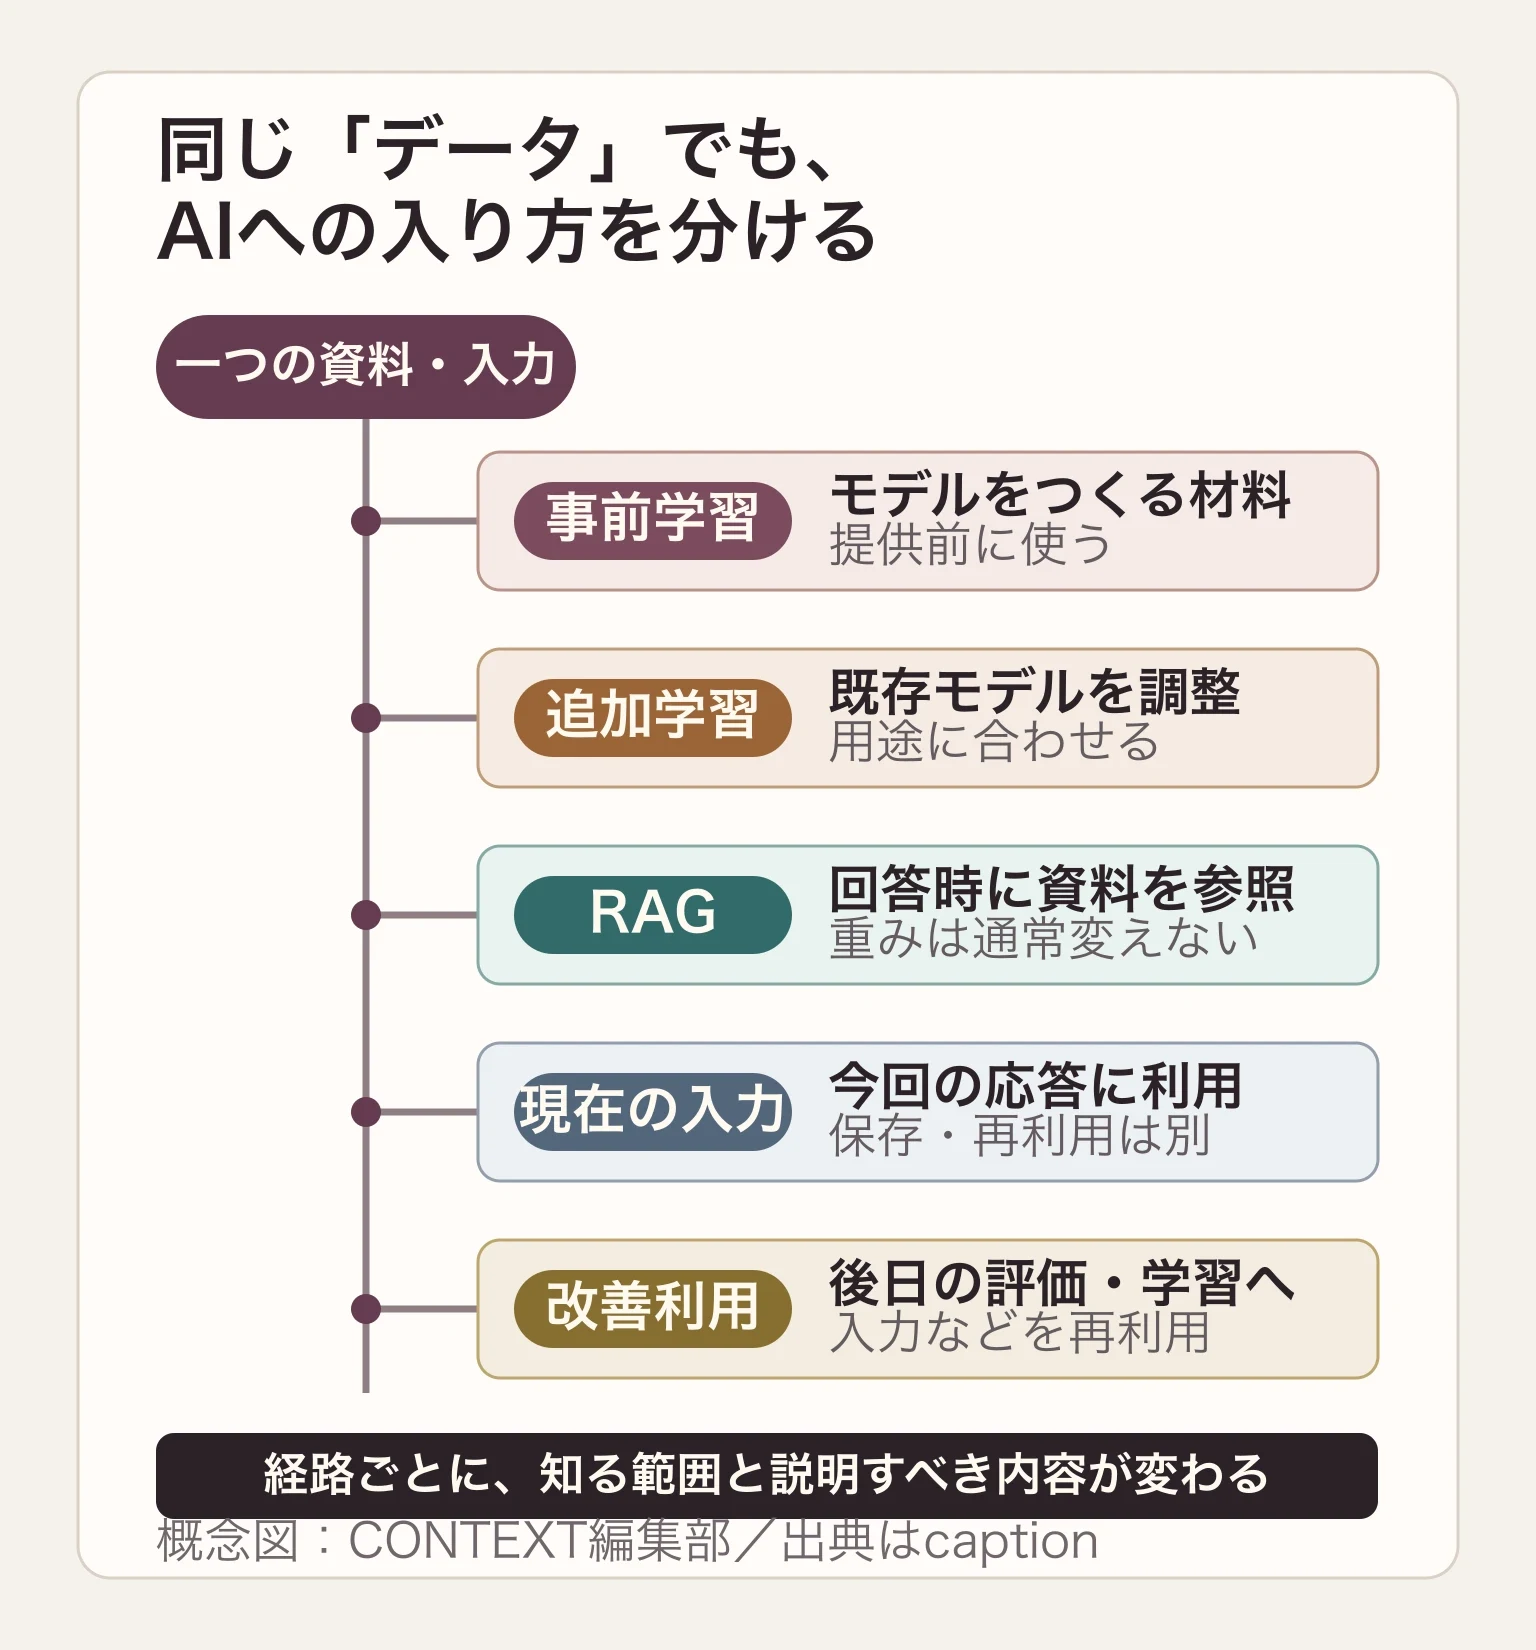
答えがずれるのは、事前学習、追加学習、RAG、現在の入力、後日の改善利用を、すべて `学習データ` と呼ぶからである。データの入り方を分けなければ、詳しく説明しても質問への答えにならない。
学習データの全件一覧を常に公開する、と決めつけなくてよい。まず自社が開発者、提供者、利用者のどの役割を持つかを定める。データの種類、主な出所、用途、処理、更新時点、既知の偏りと限界を、相手が判断できる粒度で説明する。
公開できない詳細は理由を示し、分からない範囲はそう書く。社内には出所、契約、収集・除外、版、評価、変更理由を残す。説明責任は秘密をなくすことではなく、質問へ答え、後から判断を確かめられる状態をつくることである。[1][2][3]
本稿は2026年10月21日時点の公的資料を基にした実務整理で、個別の法的義務を確定しない。個人データ、第三者の権利、重大な判断、EU向けモデル提供は専門担当へ確認する。
まず、何を「学習データ」と呼んでいるか分ける
説明票の最初の列にはデータの名前ではなく `AIへどう入るか` を書く。同じ顧客文書でも、モデルをつくる材料、回答時に検索する資料、今回の質問、後で品質改善へ回すログでは、使われる時点も企業が管理できる範囲も違う。
- 事前学習:広い用途の基盤モデルをつくるため、提供前に使われたデータ
- 追加学習:特定用途へ調整するため、既存モデルをさらに学習させるデータ
- RAG:回答するときに検索して参照する資料。通常は参照だけでモデルの重みを変えない
- 現在の入力:今回の回答を得るために送るプロンプト、添付、会話履歴
- 改善利用:入力、出力、評価、フィードバックを、後日の学習や品質評価へ再利用すること
事前学習と追加学習では、データからモデルの内部パラメータがつくられ、または調整される。RAGは質問に合わせて外部資料を探し、その内容を回答生成の参考へ加える仕組みである。資料をRAGへ登録しただけなら、基盤モデルを再学習したとは限らない。[1][4]
現在の入力も自動的に学習データになるとは限らない。一方で、規約や設定によっては保存され、評価やサービス改善へ使われることがある。`回答に使う`、`保存する`、`後で学習に使う` を別の質問にする。
例えば、顧客の契約書を社内RAGへ登録し、外部AIへ質問文を送るサービスを考える。契約書はRAGの参照資料であり、質問文は現在の入力である。外部AIの事前学習データはベンダー側にあり、入力ログが改善へ回るかは契約、設定、運用で決まる。
説明する範囲は、開発者・提供者・利用者で変わる
次に、自社の役割を一つに決めつけず、機能ごとに整理する。基盤モデルは利用者でも、自社データで追加学習すれば、その部分では開発側の情報を持つ。外部モデルを組み込み顧客へAI機能を届けるなら、サービス提供者としてデータの流れを説明する立場になる。
| 役割 | 知り得る範囲 | 主な相手 |
|---|---|---|
| 開発者 | 収集方針、データの種類・出所、学習・評価方法、除外、モデル更新 | 提供者、導入先、権利者、当局 |
| 提供者 | 基盤モデルと版、自社の追加学習・RAG、入力の送信先、保存・再利用、運用上の限界 | 顧客、利用者、影響を受ける人 |
| 利用者 | 利用目的、入力するデータ、人の確認、採用したベンダー資料と契約、業務上の判断 | 顧客、従業員、評価対象者、社内責任者 |
日本のAI事業者ガイドライン第1.2版は、開発者、提供者、利用者を分けている。透明性は社会的な文脈を踏まえ、必要かつ技術的に可能な範囲で情報を届ける考え方である。アカウンタビリティも役割とリスクに応じた合理的な範囲で求めている。[1]
したがって、全社共通の短い宣言だけでは足りない場合がある。商品紹介ページでは利用目的、データの流れ、主要な限界を平易に示す。顧客の調達資料では保存期間、再利用、委託先、設定を具体化する。権利者や当局からの照会には、社内記録へ戻って個別に答える。
人の採用、与信、医療、教育のように、出力が個人へ大きな不利益を与え得る場面では、説明の目的も変わる。一般的なデータ方針だけでなく、どの情報が判断へ影響したか、人がどこで確認したか、本人が異議を伝える方法まで必要になる。
OECDのAI原則も役割、文脈、行動できる能力に応じた責任を置く。データセット、工程、ライフサイクル中の意思決定を追跡し、出力の分析や問い合わせ対応へ使えるようにする考え方である。[3]
外部には、種類・出所・扱い・限界を伝える
外部向けの説明はデータセット名の羅列から始めない。読み手が知りたいのは、自分や自社の情報がどこへ入り、何に使われ、どんな問題が残るかである。説明する対象のサービス名、機能、モデル、版、更新日を最初に固定する。
- 種類:テキスト、画像、音声、コード、顧客データ、合成データなど
- 主な出所:公開情報、許諾・購入データ、自社データ、利用者の入力など
- 用途:事前学習、追加学習、RAG、今回の回答、評価・改善のどれか
- 扱い:収集期間、選別、重複除去、匿名化、除外、削除・訂正への対応
- 限界:未確認の出所、偏り、対象外の言語・地域、更新の遅れ、説明できない理由
- 対応:問い合わせ先、異議や削除の申出方法、説明を更新した日
`公開情報を使用` だけでは出所も扱いも判断できない。Webから収集したのか、公開データセットを使ったのか、権利者から許諾を得たのかを分ける。収集した時期、除外方針、個人情報や違法コンテンツへの対策、既知の偏りも、確認できる範囲で示す。
ただし、個々のデータ、個人情報、ソースコード、営業秘密をすべて一般公開することとは違う。日本のガイドラインは、情報提供がアルゴリズムやソースコードの開示を必ずしも意味しないとする。OECDも文脈に合う有意味な情報と、知的財産・プライバシーの両立を示している。[1][2]
非公開部分があるなら、説明全体を空欄にしない。`第三者との契約と営業秘密のため個別名称は非公開` と理由を示す。そのうえで、データの種類、入手方法の区分、収集期間、処理、件数の幅、確認済み事項、残る不明点など、判断に使える集約情報を出す。
EUではEU市場へ汎用AIモデルを提供する事業者に、学習内容の公開サマリーが求められる。欧州委員会のテンプレートは一般情報、データ源、処理の三部で共通の最低線を定める。データ源は公開・非公開のデータセット、Web収集、利用者データ、合成データなどに分ける。[5]
この義務は2025年8月2日から適用され、欧州委員会は違反への執行を2026年8月2日から行い得ると説明する。同日より前に市場へ出たモデルには2027年8月2日までの経過措置がある。情報を得られない、または取得負担が過大な箇所は、欠落と理由を明示する考え方である。営業秘密に配慮し、データ源ごとに求める詳細度も変えている。[5]

これは、外部AIを一機能で使うすべての日本企業へ、同じテンプレートを義務付ける話ではない。自社が汎用AIモデルの提供者に当たるかは別に確認する。生成物やAIとの対話をどう表示するかも別論点であり、EU AI Act Article 50の透明性で扱った。
社内では、公開文より詳しく出所と変更を残す
外部説明を作る前に、社内のデータ台帳を整える。公開ページだけを先に書くと、モデル更新や問い合わせのたびに根拠が見つからない。台帳では一つのデータ源を、使われる機能、モデルの版、判断した人へ結ぶ。
- 対象:サービス、機能、基盤モデル、モデル版、提供者、適用する設定
- 出所:データセット、取得元、収集日、作成者、対象期間、由来を示す資料
- 根拠:許諾、契約、利用規約、同意、社内保有の理由、確認した日
- 処理:選別、重複除去、匿名化、ラベル付け、除外、削除、訂正
- 経路:事前学習、追加学習、RAG、現在の入力、評価・改善
- 評価:品質、偏り、個人情報、権利、セキュリティ、既知の不具合
- 変更:追加・削除したデータ、モデル更新、理由、承認者、公開説明の更新
NISTの生成AI向けAI RMFプロファイルは、任意に使うリスク管理資料である。学習データと生成データの由来や履歴を文書化する方針、可能な範囲での学習データ選定方針、第三者データの利用・保管・保護を定めることを提案している。[4]
同資料は学習データの出所と種類、潜在的な偏り、事前学習モデル、追加学習やRAGの情報も記録対象に挙げる。完全に見えることを前提にせず、データ由来の情報が不足する箇所や限界も文書化する。[4]
日本のAI事業者ガイドラインも、開発過程、データ収集、ラベル付け、アルゴリズムを第三者が検証できる形で文書化するよう示す。同時に、その文書をすべて開示する意味ではないと注記する。外部説明と内部証跡を分ける根拠になる。[1]
記録は問い合わせに答えるための道具である。`私の作品が使われたか`、`削除後のモデルにも残るか`、`新しい版で入力の扱いが変わったか` と聞かれたとき、確認できる事実、確認できない事実、追加調査の担当と期限を返せるようにする。
信頼できる専門情報を自社で持つことと、それをどのAI工程へ使うかも別である。Thomson Reutersの自社AIのような事例を見るときも、情報資産の質だけでなく、モデル、検索、専門家の確認を分けて読む。
既製AIを使う企業は、分からないことまで言わない
既製AIの利用企業は基盤モデルの学習データを自社で見られないことがある。その場合、`権利処理済みです`、`個人情報は含みません` と断定しない。ベンダーの公開サマリー、モデルカード、規約、プライバシーポリシー、契約回答から確認できた範囲だけを書く。
- どのサービス、モデル、版を使い、変更時に通知されるか
- 自社や顧客の入力、添付、出力、評価はどこへ送られ、何日保存されるか
- 入力は今回の応答だけに使うか、サービス改善、評価、一般学習にも使うか
- 学習・改善利用を止める設定や契約は、全利用者と全機能へ適用されるか
- 自社の追加学習、RAG、顧客別データは他の顧客から分離されるか
- 削除、訂正、事故、権利者からの申立て、規約変更へ誰が答えるか
個人情報保護委員会は、企業が個人データを含むプロンプトを本人の同意なく入力する場面へ注意を促している。応答を出す以外の目的で扱われる場合、法違反となる可能性があるため、提供者が機械学習に利用しないことなどを十分確認するよう求める。[6]
ここで確認するのは、導入後に企業が送る個人データの扱いである。基盤モデルが過去に何で事前学習されたかという質問とは分ける。社内ルールを `個人情報を入れない` で終えず、例外的に必要な業務、同意、契約、設定、代替手段を決める。
外部向けには例えば次の形で書ける。`当社は問い合わせ要約に外部AIのモデルA・版Bを使う。基盤モデルの学習内容は提供者の公開資料Cの範囲で確認している。当社のFAQはRAGで参照し、顧客入力は契約上、一般モデルの学習へ使われない。保存期間と例外はDに示す`。
この例で埋められない欄があれば、そのまま課題にする。ベンダーが質問へ答えない、設定の適用範囲が曖昧、モデル版が分からない、入力の保存期間が変わり得るなら、利用範囲を狭めるか、契約条件を加える。重大な用途では代替サービスや人だけの手順も残す。
AIを使った事実の表示は、データ説明とは別に設計する。企業は生成AIの利用をどこまで開示すべきかで整理した通り、方針、個別表示、機械可読情報には別の役割がある。`AI使用` と表示しても、入力の保存や学習利用を説明したことにはならない。
個人データや機密情報を想定外の学習へ回す、権利者から具体的な申立てがある、重大な判断に使うのに出所と限界を説明できない。このどれかに当たれば、導入や公開を止める。記録を保全し、法務、プライバシー、セキュリティ、調達、開発の責任者へ渡す。
最初に、顧客から聞かれた一つの質問を選ぶ。関係するデータを、事前学習、追加学習、RAG、現在の入力、改善利用の五行へ分ける。各行に、知っていること、根拠のURLや契約、知らないこと、確認先を書く。それが外部説明と社内記録の最小単位になる。
Sources / 参考資料
2. OECD.AI:Transparency and explainability (OECD AI Principle)
3. OECD.AI:Accountability (OECD AI Principle)
4. National Institute of Standards and Technology:Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
5. European Commission:Template for general-purpose AI model providers to summarise their training content
6. 個人情報保護委員会:生成AIサービスの利用に関する注意喚起等について