営業企画の担当者が、社内ストレージの `来期価格案.xlsx` を開いている。隣のAIブラウザには、競合の公開価格を調べ、比較メモを作るよう頼んだ。価格案を入力欄へ貼ってはいない。それでも、ブラウザが閲覧中のページを読めたり、AIが社内ストレージを検索できたりすれば、資料は処理の範囲へ入り得る。
社内規程に `機密情報の入力禁止` と書くだけでは、この接続を止められない。添付、RAG、コネクター、閲覧中のページ、外部ツールの応答もAIへの入口になる。さらに、回答を共有リンクにし、別のチャットへ貼り、ログへ残せば、出口と保存先も増える。[2][4]
生成AIの機密情報対策は、一件の資料が `入る、処理される、出る、残る` までを管理する。所有者と秘密区分を確かめ、必要な情報だけを、承認済みのアカウントで、許可した機能・権限・契約条件の範囲に限定する。経路や事故対応を確認できなければ、接続も入力もしない。
本稿は2026年10月21日時点の公的資料を基にした一般的な実務整理である。個別案件の営業秘密該当性、契約違反、法的責任は確定しない。顧客秘密、共同研究、未公開M&A、ソースコード、認証情報、規制対象技術は、情報の所有者と専門担当へ確認する。
まず、秘密の資料がAIを通る一往復を書く
最初に製品名を並べるのではなく、資料を一つ選ぶ。`誰の資料を、どこから読み、どのAI機能で処理し、誰が出力を見て、どこへ保存するか` を一行で書く。来期価格案なら、営業責任者が所有し、法人ストレージから検索し、比較案を作り、担当者が確認して企画書へ戻す、という一往復になる。
- 所有者:情報の開示範囲と利用目的を決められる人は誰か
- 入口:入力、添付、社内検索、ブラウザ、ツールのどこから入るか
- 処理:どの提供者、モデル、外部サービス、国を通るか
- 権限:AIと利用者が、どのフォルダ、ページ、操作へ届くか
- 出口:回答、共有リンク、通知、書き戻しを誰が受け取るか
- 保存:会話、出力、監査ログ、バックアップがどこへ何日残るか
- 停止:誤送信や不正動作時に、誰が接続と権限を切れるか
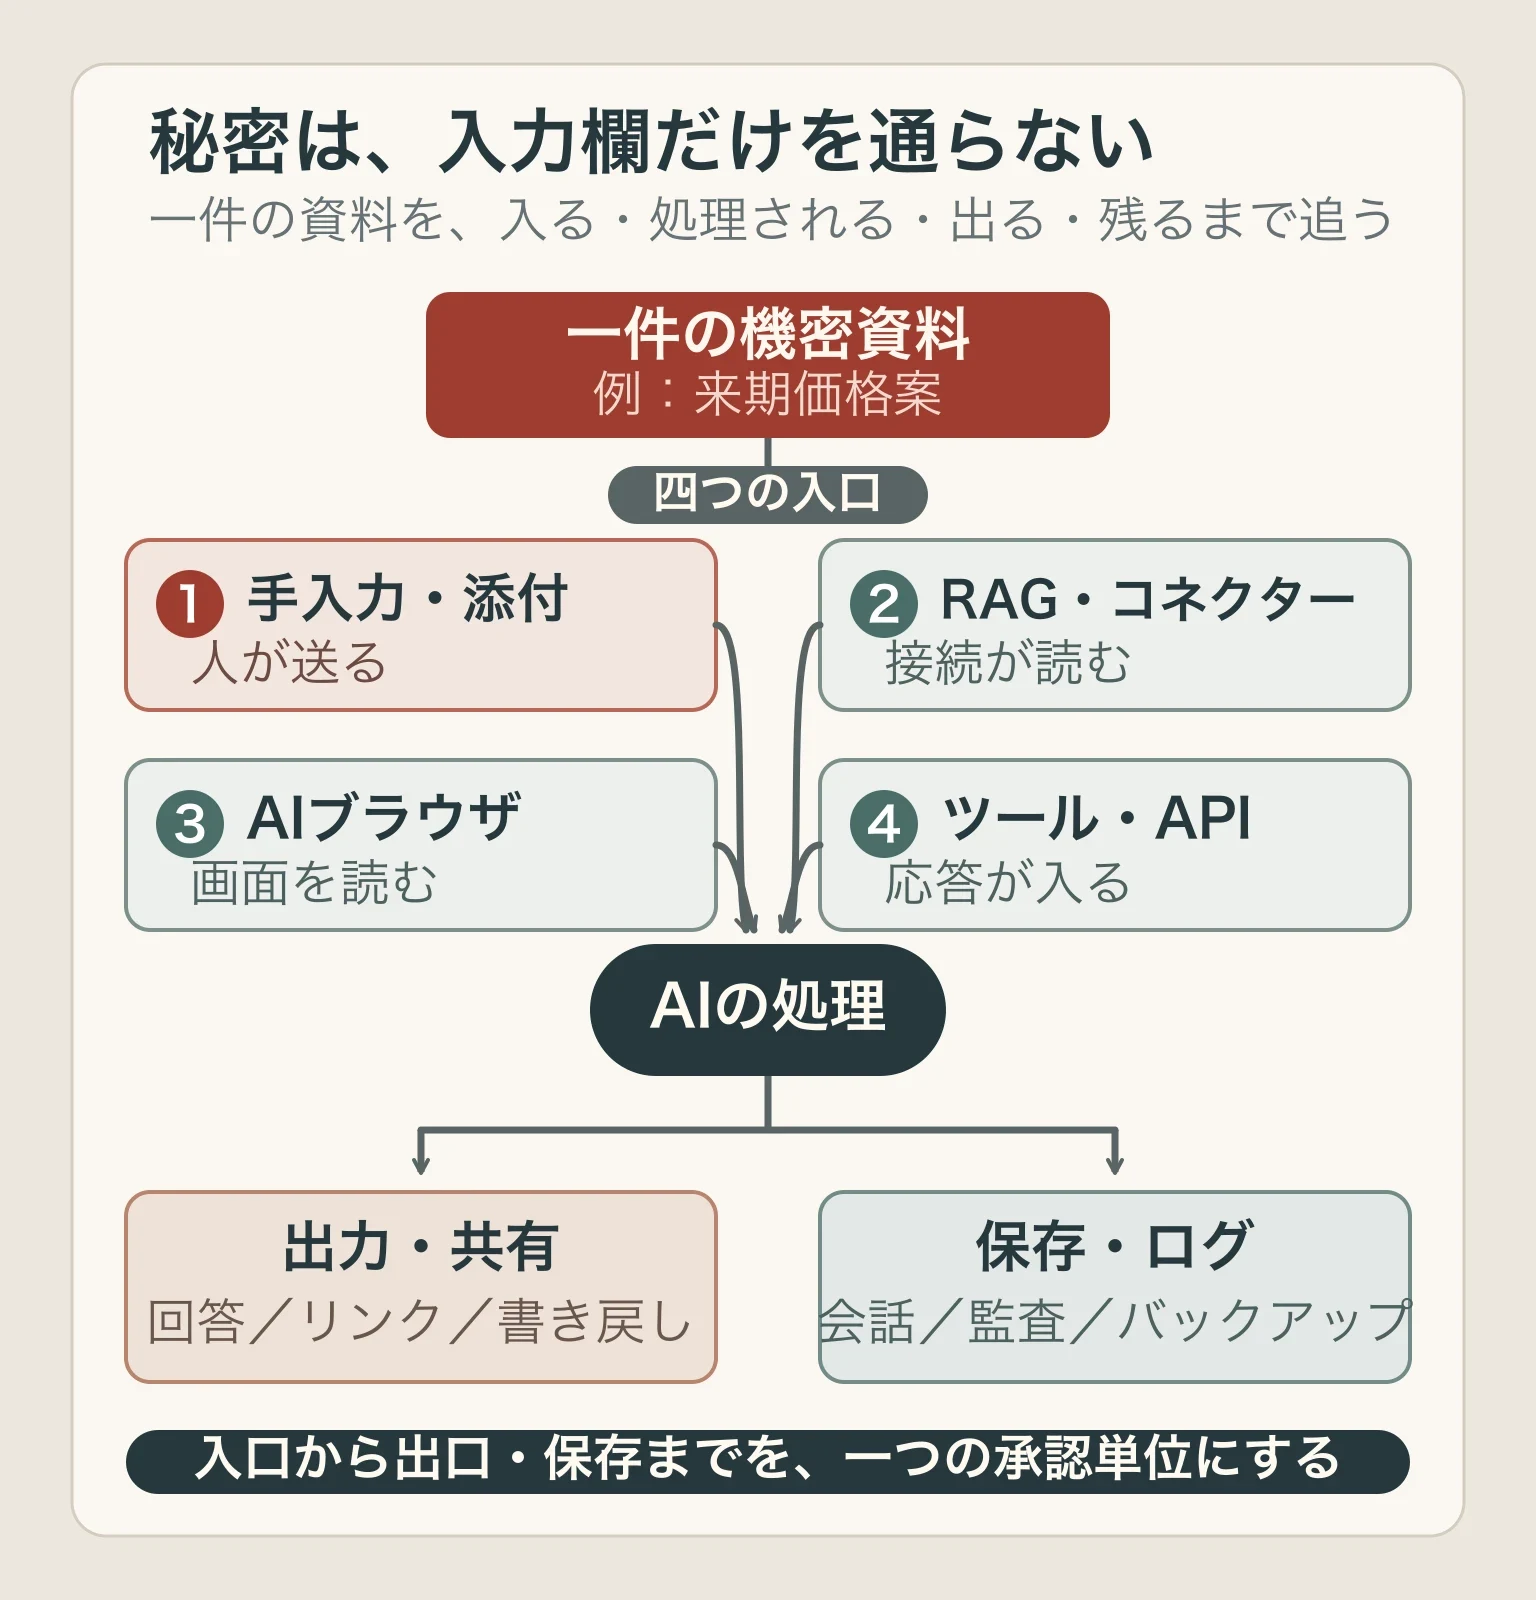
一往復を書けば、判断は三つに分けられる。秘密である必要がなければ、公開情報か架空データへ減らす。必要性があり、経路と管理条件を確認できれば、承認済み環境で範囲を限定する。所有者、契約、権限、保存先のどれかが不明なら、実データをつながない。
機密情報と法律上の営業秘密を分ける
企業が機密と呼ぶ情報のすべてが、不正競争防止法上の営業秘密とは限らない。同法は営業秘密を、秘密として管理され、事業活動に有用な技術上または営業上の情報で、公然と知られていないものと定義する。秘密管理性、有用性、非公知性の三つを事実に即して確かめる必要がある。[1]
- 法律上の営業秘密:不正競争防止法の三要件を満たすかを個別に判断する
- 契約上の秘密:顧客、委託元、共同研究先との約束で利用や開示が制限される
- 社内の機密情報:価格、原価、設計、営業計画、人事などを社内規程で区分する
- 別の規制がある情報:個人情報、認証情報、輸出管理対象など固有の条件がある
来期価格案に `社外秘` と印があっても、それだけで営業秘密の三要件を確定できない。反対に、表示を忘れたから価値がないとも決められない。誰がアクセスでき、秘密だと認識できる状態だったか。外部で一般に入手できるか。事業にどう使うかを、記録と実態から見る。
AIサービスへ送信しただけで、営業秘密性が必ず失われるとも断定できない。相手が誰か、秘密保持義務があるか、提供者や再委託先が何へ使えるか、何人がアクセスできるかで事情は変わる。法人契約を結んだだけで、必ず維持されるとも言えない。個別の事実は法務や知財担当へ渡す。
法的な名称を決める前にも、業務上の管理はできる。まず所有者が `外部サービスへ渡せるか`、`AIで使う必要があるか`、`減らせる部分はどこか` を決める。取引先から預かった情報なら、自社だけで許可せず、契約上の目的と再委託の条件も確かめる。
入口は、入力欄だけではない
第一の入口は、担当者が打ち込む文章と添付である。ここには `機密を貼らない` という教育が効く。ただし、画像、音声、圧縮ファイル、会話履歴も入力になり得る。提供者が入力を保存や学習へ使うかは、サービス規約と利用時設定を確認する。[2]
第二の入口は、RAGとコネクターである。AIが社内ストレージ、メール、チャット、顧客管理システムを検索すれば、担当者が原文を貼らなくても関連部分が処理へ入る。検索対象の広さと、元システムの閲覧権限が回答へ正しく引き継がれるかを確かめる。
第三の入口は、AIブラウザである。IPAは、AIブラウザが閲覧中のページや過去の閲覧履歴を生成AIと共有すると説明する。常用するAIブラウザから社内ポータルなど重要情報へアクセスしないよう、社内用と社外用を分ける選択肢も示している。[2]
Webページやメールには、人には普通の文章に見えても、AIへ別の行動を促す指示が埋め込まれる場合がある。これが間接プロンプトインジェクションである。IPAは、外部由来のメールと社内文書が同じRAG処理へ入ると、社内情報が外へ流れる可能性を挙げ、検索範囲の制限を促す。[2]
第四の入口は、AIが呼び出すツール、API、別のAIである。英国NCSCは、モデルへの不正な入力が参照データベースだけでなく、システム入力、ツール応答、他のエージェントから来る可能性を示す。チャット画面だけを監視しても、裏側の呼び出しは見えない。[4]
危険なのは、AIに秘密が見えることだけではない。外部情報を読む機能と、社内情報を読む機能と、送信や書き込みを行う機能が同時にあると、意図しない組合せが生まれる。外部Webの調査に使うAIへ、価格表のフォルダとメール送信権限を同時に与える必要があるかを問い直す。
入口を通った情報は、回答、通知、共有リンク、別システムへの書き戻しへ進む。提供者の会話履歴、品質評価、障害調査、社内の監査ログ、バックアップへ複製されることもある。英国NCSCは、データがどこでどう利用、アクセス、保存されるかを明らかにするよう求める。[5]
- AIが自動検索できる情報源を一覧にできるか
- 外部由来のページやメールと、内部の秘密資料を同時に読ませていないか
- 読み取り、送信、更新、削除の権限を分けているか
- 出力を受け取る人と、共有リンクを開ける人を限定できるか
- 提供者と社内のログへ、秘密の原文を残す必要が本当にあるか
サービス名ではなく、機能と権限ごとに許可する
`このAIは利用可` という承認は粗すぎる。同じサービスでも、個人アカウントと法人アカウント、通常チャットとファイル検索、Web閲覧と社内接続、下書き作成と自動送信では経路が違う。承認単位を `業務、データ区分、アカウント、モデル、機能、権限` の組にする。
- 業務:公開情報の要約、社内検索、コード補助など、目的を一つにする
- データ:一般、社内限定、顧客秘密、営業秘密候補など対象を決める
- 契約:保存、再利用、人の閲覧、再委託、国、削除、事故連絡を確かめる
- 設定:履歴、学習、共有、Web閲覧、外部連携を承認内容へそろえる
- 権限:必要なフォルダと操作だけを許し、管理者権限を与えない
- 試験:架空データで検索範囲、出力、共有、停止、削除を実際に試す
- 見直し:モデル、機能、規約、再委託先、業務が変われば再承認する
機密情報を扱うことと、外部AIを一律に禁止することは同じではない。デジタル庁の生成AI利用環境 `源内` は、政府統一基準に準拠し、デジタル庁では機密性2情報を含むプロンプト入力に対応する。これは安全性の一般証明ではなく、扱う情報に合わせて環境を設計し、入口を指定する実例である。[3]
2026年10月20日に公表された `源内基準` も、入力できる情報の範囲と条件は、実行環境、モデル、アプリ、機能、各府省庁のルールによって変わると明記する。利用者、管理者、開発者の役割も分けている。製品名を許可リストへ載せるだけでなく、どの環境と機能で、誰が何を管理するかまで決める必要がある。[7]
権限は、利用者が普段見られる範囲をそのままAIへ渡せばよいとは限らない。AIは短時間に多数の資料を検索し、組み合わせ、別の操作へ使える。英国NCSCは、API、モデル、データへ適切なアクセス制御を置き、機微な情報を持つ環境を分離するよう求める。使わないコネクターと書き込み権限は、初期状態で外す。[5]
導入試験に本物の秘密を使わない。架空の価格表へ識別用の文字列を入れ、検索対象外のフォルダを読まないか、別部署の利用者へ回答しないか、共有リンクが組織外で開かないかを試す。異常時にコネクター、APIキー、利用者権限をすぐ止められることも確認する。
禁止を厳しくするだけでは、現場が必要な仕事を未承認AIへ移すことがある。英国NCSCは、方針が業務ニーズへ追いつかないと未承認ツールの利用につながり、組織がデータの可視性と統制を失い得ると指摘する。安全な代替手段と相談窓口を、禁止と同時に用意する。[6]
誰が承認し、誰が機能変更を追い、誰が事故時に止めるかは、全社のルールへつなぐ。生成AI利用ガイドラインは、禁止事項より先に責任者を決めるで、業務ごとの所有者、例外、見直しの置き方を整理した。
契約では `学習しない` の一文だけを探さない。今回の応答に使う範囲、会話と添付の保存、人による不正利用監視、再委託、外部ツールへの送信、契約終了時の返却・削除を分ける。英国NCSCも、再学習や従業員・パートナーの確認を含め、データがどこでどう使われ、アクセスされ、保存されるかを明示するよう求める。[5]
提供者へ何を尋ねるかは、生成AIの学習データを企業はどこまで説明すべきかで、事前学習、RAG、現在の入力、後日の改善利用に分けた。個人情報も含む場合は、生成AIへ個人情報を入力するとき、企業は何を確認すべきかの利用目的、委託、本人対応も重ねる。
出力・共有・ログから逆算して止める
秘密資料を要約しても、生成文が自動的に公開情報へ変わるわけではない。来期価格案から具体的な値上げ幅、対象顧客、原価の前提を残せば、元の情報を推測できる。出力は `AIが作った文` ではなく、含まれる情報と利用目的で区分し直す。
共有機能にも境界を置く。リンクを知る全員が開ける設定にしない。組織外への共有、検索エンジンによる取得、期限切れ、再共有、ダウンロードを確認する。メール、チャット、文書管理へ書き戻す場合は、送信前の人による確認と、宛先・公開範囲の再確認を外せないようにする。
監査ログは、増やせば安全になるとは限らない。プロンプト全文と出力を別基盤へ複製すれば、守る場所が増える。誰が、いつ、どの業務とデータ区分で、どの機能を使ったかを基本にする。原文が事故調査に必要なら、閲覧者、保存期間、削除方法を限定する。
- 止める:対象アカウント、コネクター、APIキー、共有リンクを無効にする
- 特定する:入力、参照元、出力、受信者、保存先、時刻を記録から追う
- 連絡する:情報所有者、セキュリティ、法務、提供者の事故窓口へ渡す
- 残す:原因確認に必要な証拠を、閲覧範囲と期間を決めて保全する
- 判断する:契約先、本人、当局への報告・通知の要否を個別に確認する
- 直す:権限、検索範囲、設定、教育を更新し、同じ経路を再試験する
利用前に中止条件を決める。所有者の許可がない。外部ツールへの送信先を確認できない。元の閲覧権限を回答へ引き継げない。保存期間や削除範囲が不明である。事故時に接続を止められない。一つでも当てはまれば、本物の資料を使わず、機能を切るか架空データへ戻す。
最小の確認票は一ページでよい。業務名、資料名、所有者、秘密区分、契約上の制約を書く。入口、処理先、権限、出力先、保存期間、削除方法、停止担当、見直し日を続ける。サービス全体の安全評価ではなく、この一件をこの機能で扱えるかに答える。
結論は三つにする。公開情報や架空データで足りるなら、秘密を接続しない。秘密の一部が必要なら、所有者の承認を得て情報を減らす。秘密そのものが必要なら、契約、設定、権限、出力、保存、事故対応を確認した環境へ限定する。確認できない空欄を、現場の注意力で埋めない。
生成AIの機密情報対策は、入力欄の前で終わらない。一件の資料を選び、誰のものかを確かめ、すべての入口と出口を描く。業務に不要な接続と権限を外し、必要な利用だけを承認済み環境へ狭める。止め方まで試せて初めて、入力禁止を実際の管理へ変えられる。
Sources / 参考資料
2. 情報処理推進機構/AIセーフティ・インスティテュート:AI利用者のためのセキュリティ豆知識
3. デジタル庁:ガバメントAI「源内」
4. UK National Cyber Security Centre:Understanding adversarial attacks against Machine Learning and AI
5. UK National Cyber Security Centre and international partners:Guidelines for secure AI system development: Secure deployment
6. UK National Cyber Security Centre:The hidden risks of shadow AI
7. デジタル庁:源内基準